POL-2000 · Méthodologie quantitative
Préparer ses données avec R
Séance 4 · jeudi 24 septembre 2026
 Département de science politique
Faculté des sciences sociales Automne 2026
Préparer ses données avec R
Lire un codebook, recoder, gérer les valeurs manquantes.
L'examen 1 ouvre aujourd'hui.
Des questions sur la semaine dernière ?
Notre objectif
Des données tidy
« Les jeux de données bien rangés se ressemblent tous. Chaque jeu de données désordonné l’est à sa façon. » Hadley Wickham, « Tidy Data », 2014
POURQUOI Le format tidy, c’est le chemin de moindre résistance pour l’analyse.
Le vrai travail
Wickham (2014), d’après Dasu et Johnson (2003)
Du brut au propre
- 1Lire le codebook
- 2Renommer
- 3Traduire les codes
- 4-99 devient NA
df_raw20 180 lignes × 1 440 colonnesinchangé df_clean20 180 lignes × 7 colonnesnouveauÉtude électorale canadienne 2025 · quatre vraies personnes
Un tableau, vu de près
Étude électorale canadienne 2025 · les cinq premières lignes
Trois règles
1Chaque colonne est une variable.
2Chaque ligne est une observation.
3Chaque tableau est un type d’unité observée.
Wickham (2014), « Tidy Data »
Des valeurs dans les en-têtes
Les tranches de revenu sont des valeurs, pas des variables.
| religion | <$10k | $10-20k | $20-30k |
|---|---|---|---|
| Agnostic | 27 | 34 | 60 |
| Atheist | 12 | 27 | 37 |
| Buddhist | 27 | 21 | 30 |
| … 11 colonnes | |||
Revenu et religion aux États-Unis, Pew Research Center · tidyr::relig_income
Les tranches de revenu en une colonne
relig_income |>
  pivot_longer(!religion, names_to = "revenu", values_to = "n")
| religion | <$10k | $10-20k | $20-30k |
|---|---|---|---|
| Agnostic | 27 | 34 | 60 |
| Atheist | 12 | 27 | 37 |
| Buddhist | 27 | 21 | 30 |
| … 11 colonnes | |||
| religion | revenu | n |
|---|---|---|
| Agnostic | <$10k | 27 |
| Agnostic | $10-20k | 34 |
| Agnostic | $20-30k | 60 |
| Agnostic | $30-40k | 81 |
| Agnostic | $40-50k | 76 |
| … 180 lignes | ||
Plusieurs variables dans une colonne
sp_m_014 cache trois variables : le diagnostic, le sexe, l’âge.
| country | year | sp_ | sp_ | sp_ | sp_ |
|---|---|---|---|---|---|
| Canada | 2010 | 3 | 30 | 1 | 28 |
| … 58 colonnes | |||||
Cas de tuberculose, Canada 2010, Organisation mondiale de la santé · tidyr::who2
Trois variables, trois colonnes
who2 |>
  pivot_longer(!c(country, year),
               names_to = c("diagnostic", "sexe", "age"), names_sep = "_",
               values_to = "cas", values_drop_na = TRUE)
| country | year | sp_ | sp_ | sp_ | sp_ |
|---|---|---|---|---|---|
| Canada | 2010 | 3 | 30 | 1 | 28 |
| … 58 colonnes | |||||
| country | year | diagnostic | sexe | age | cas |
|---|---|---|---|---|---|
| Canada | 2010 | sp | m | 014 | 3 |
| Canada | 2010 | sp | m | 1524 | 30 |
| Canada | 2010 | sp | f | 014 | 1 |
| Canada | 2010 | sp | f | 1524 | 28 |
| … 76 046 lignes | |||||
Des variables dans les lignes et les colonnes
Les jours sont en colonnes, les deux températures en lignes.
| id | mesure | d1 | d2 | d3 | d4 |
|---|---|---|---|---|---|
| MX17004 | tmax | NA | 27.3 | 24.1 | NA |
| MX17004 | tmin | NA | 14.4 | 14.4 | NA |
Station météo MX17004, Mexique, février 2010 · Global Historical Climatology Network, vignette « Tidy data » de tidyr
Les jours en lignes, les températures en colonnes
meteo |>
  pivot_longer(d1:d4, names_to = "jour", values_to = "temp", values_drop_na = TRUE) |>
  pivot_wider(names_from = mesure, values_from = temp)
| id | mesure | d1 | d2 | d3 | d4 |
|---|---|---|---|---|---|
| MX17004 | tmax | NA | 27.3 | 24.1 | NA |
| MX17004 | tmin | NA | 14.4 | 14.4 | NA |
| id | jour | tmax | tmin |
|---|---|---|---|
| MX17004 | d2 | 27.3 | 14.4 |
| MX17004 | d3 | 24.1 | 14.4 |
Plusieurs observations dans une ligne
Une observation : une chanson, une semaine.
| artist | track | wk1 | wk2 | wk3 |
|---|---|---|---|---|
| 2 Pac | Baby Don't Cry | 87 | 82 | 72 |
| 2Ge+her | The Hardest Pa | 91 | 87 | 92 |
| … 79 colonnes | ||||
Palmarès Billboard, 2000 · tidyr::billboard
Une ligne par chanson et par semaine
billboard |>
  select(artist, track, starts_with("wk")) |>
  pivot_longer(starts_with("wk"), names_to = "semaine", names_prefix = "wk",
               values_to = "rang", values_drop_na = TRUE)
| artist | track | wk1 | wk2 | wk3 |
|---|---|---|---|---|
| 2 Pac | Baby Don't Cry | 87 | 82 | 72 |
| 2Ge+her | The Hardest Pa | 91 | 87 | 92 |
| … 79 colonnes | ||||
| artist | track | semaine | rang |
|---|---|---|---|
| 2 Pac | Baby Don't Cry | 1 | 87 |
| 2 Pac | Baby Don't Cry | 2 | 82 |
| 2 Pac | Baby Don't Cry | 3 | 72 |
| 2 Pac | Baby Don't Cry | 4 | 77 |
| 2 Pac | Baby Don't Cry | 5 | 87 |
| 2 Pac | Baby Don't Cry | 6 | 94 |
| … 5 307 lignes | |||
Une observation dans plusieurs tableaux
Mêmes partis, mêmes colonnes, un fichier par élection.
| parti | sieges |
|---|---|
| PLC | 160 |
| PCC | 119 |
| BQ | 32 |
| NPD | 25 |
| PV | 2 |
| parti | sieges |
|---|---|
| PLC | 169 |
| PCC | 144 |
| BQ | 22 |
| NPD | 7 |
| PV | 1 |
Sièges à la Chambre des communes, élections de 2021 et 2025 · Élections Canada
Un seul tableau, avec l’année
bind_rows("2021" = sieges_2021, "2025" = sieges_2025, .id = "annee")
| parti | sieges |
|---|---|
| PLC | 160 |
| PCC | 119 |
| BQ | 32 |
| NPD | 25 |
| PV | 2 |
| parti | sieges |
|---|---|
| PLC | 169 |
| PCC | 144 |
| BQ | 22 |
| NPD | 7 |
| PV | 1 |
| annee | parti | sieges |
|---|---|---|
| 2021 | PLC | 160 |
| 2021 | PCC | 119 |
| 2021 | BQ | 32 |
| 2021 | NPD | 25 |
| 2021 | PV | 2 |
| 2025 | PLC | 169 |
| 2025 | PCC | 144 |
| 2025 | BQ | 22 |
| 2025 | NPD | 7 |
| 2025 | PV | 1 |
Les cinq problèmes
pivot_longer()pivot_longer(names_sep = )pivot_longer() + pivot_wider()pivot_longer()bind_rows()Wickham (2014), « Tidy Data »
Le codebook
Le dictionnaire des données.
Le codebook de 1993
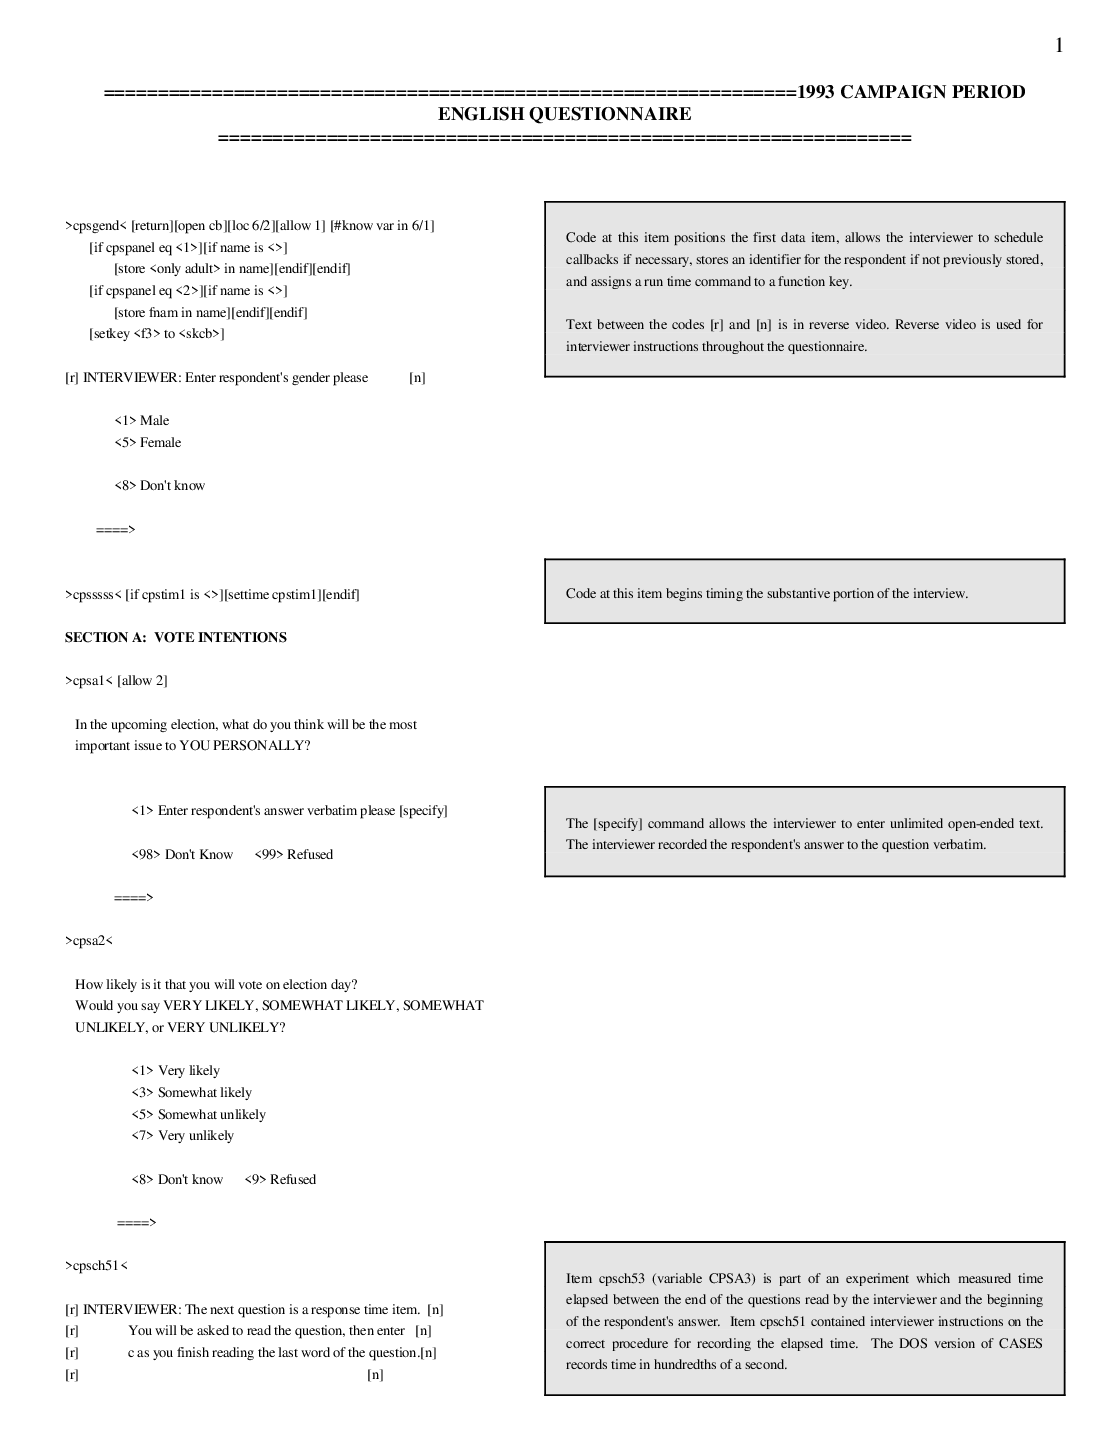
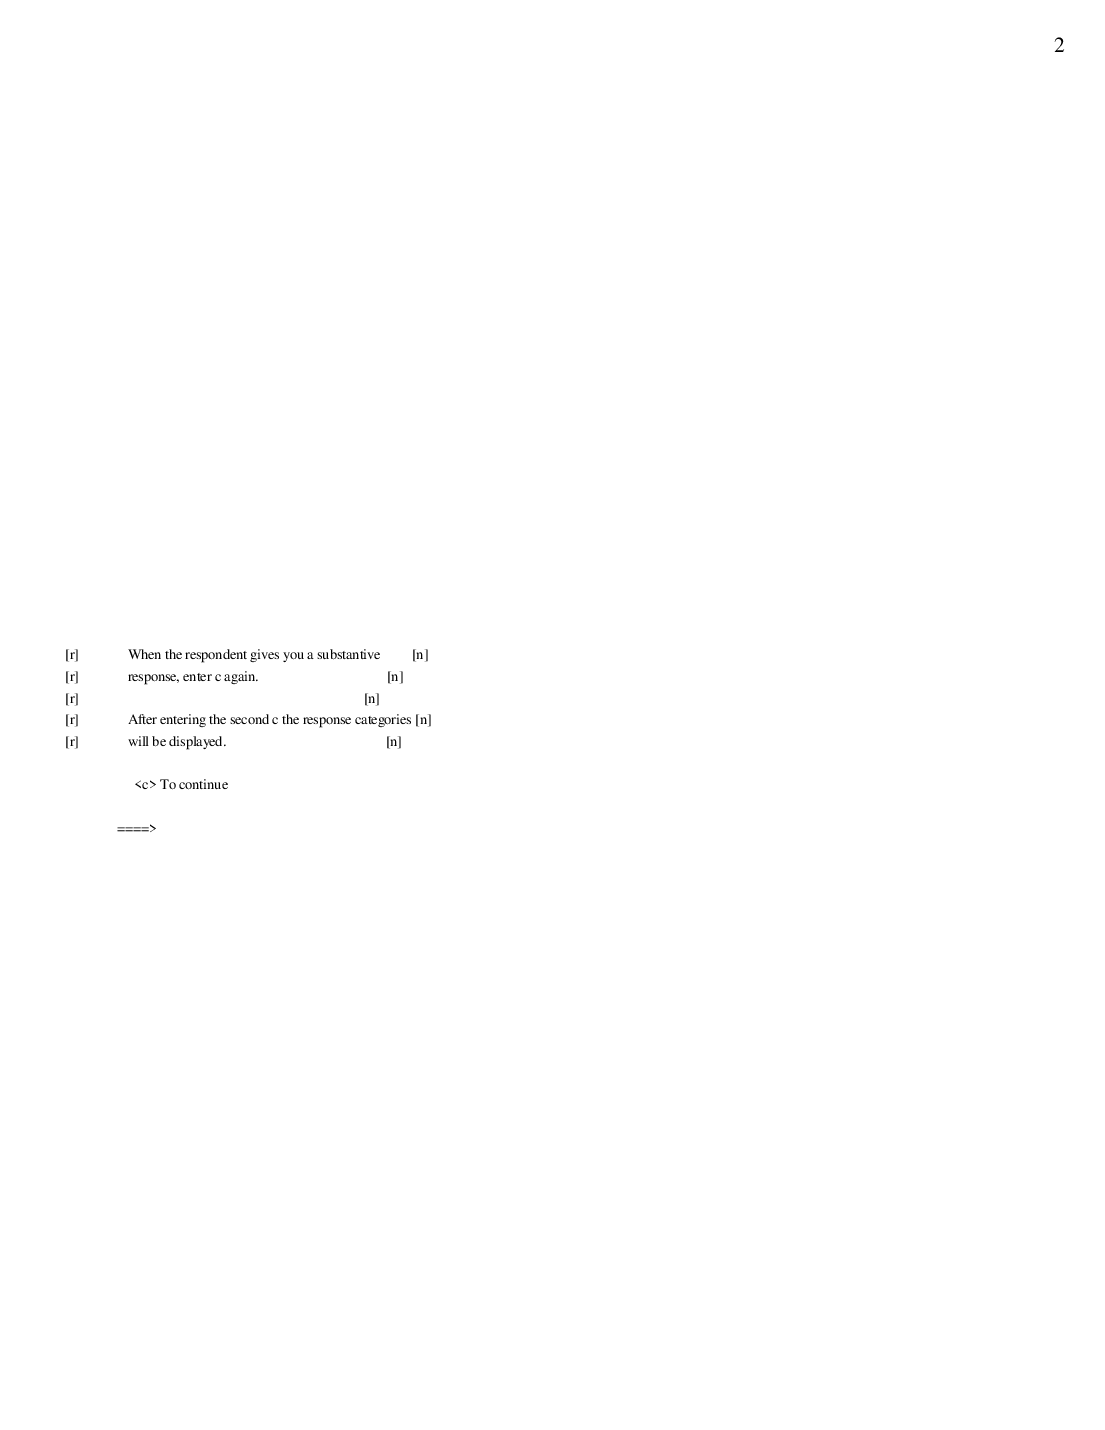
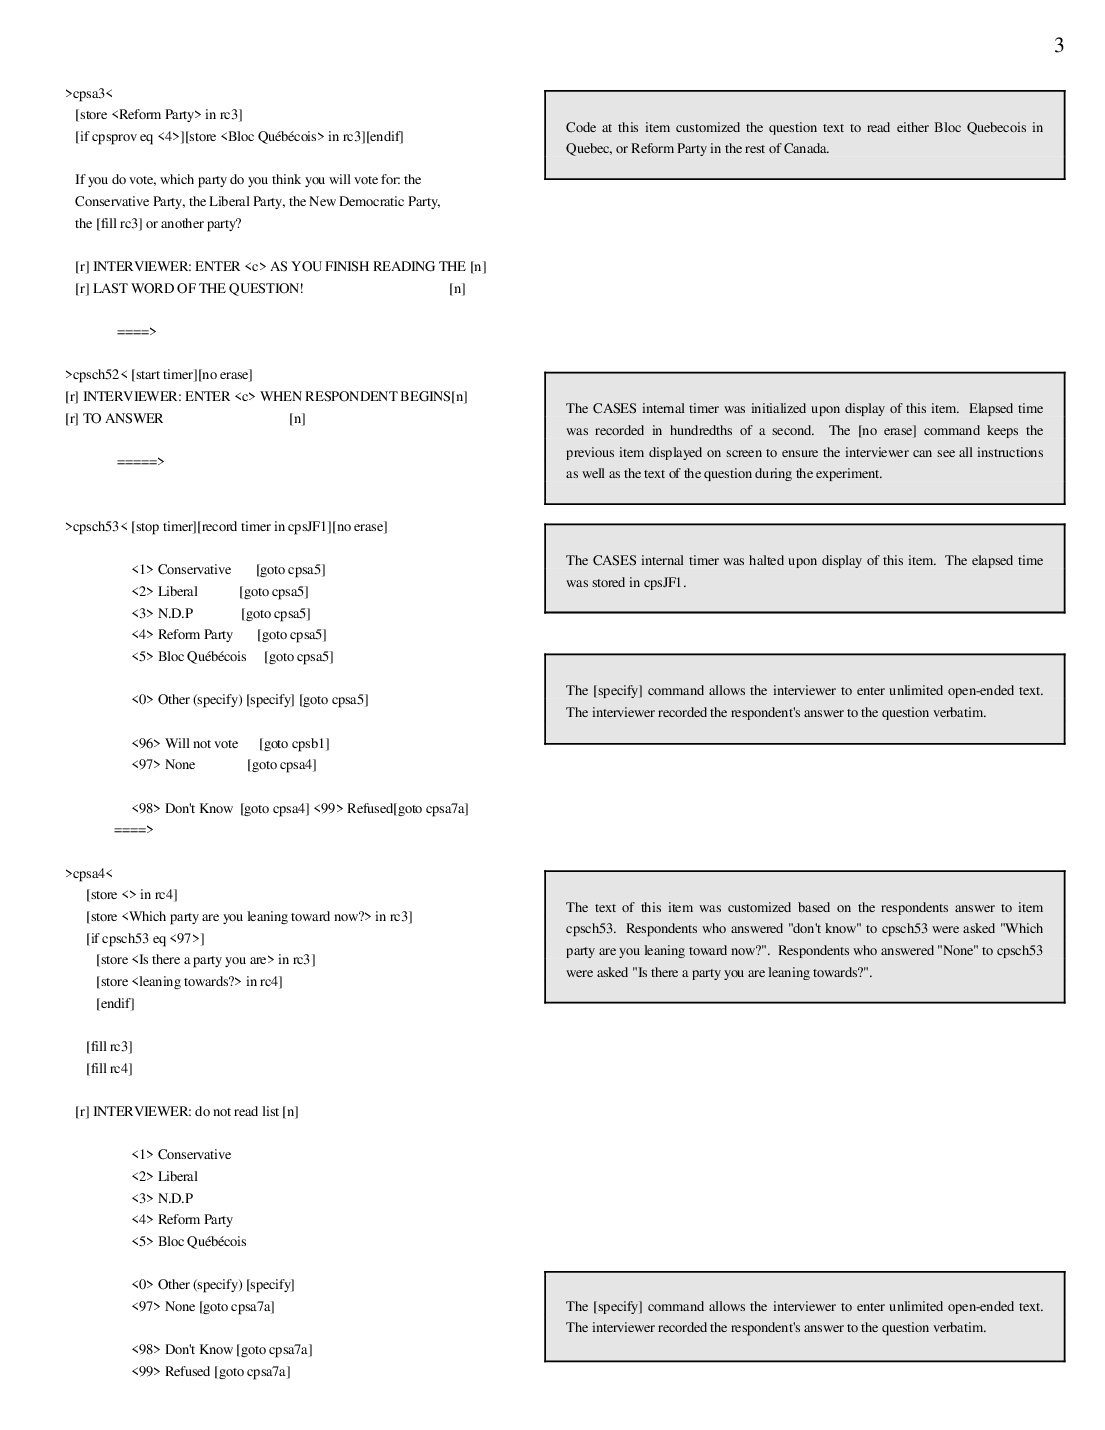
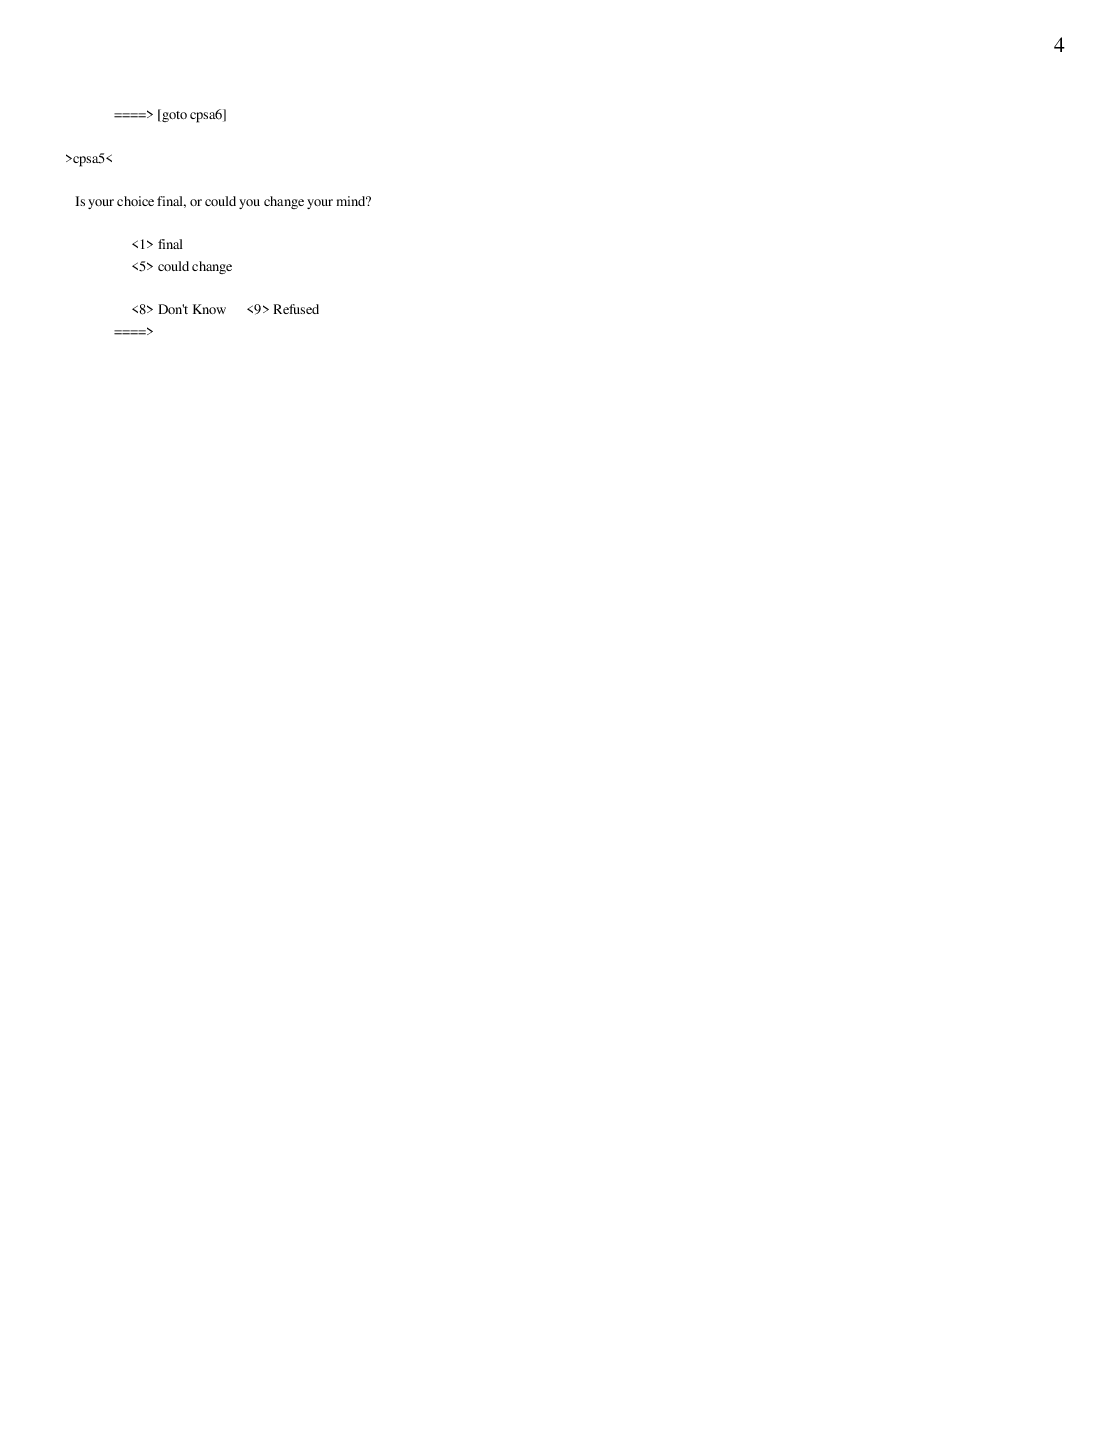
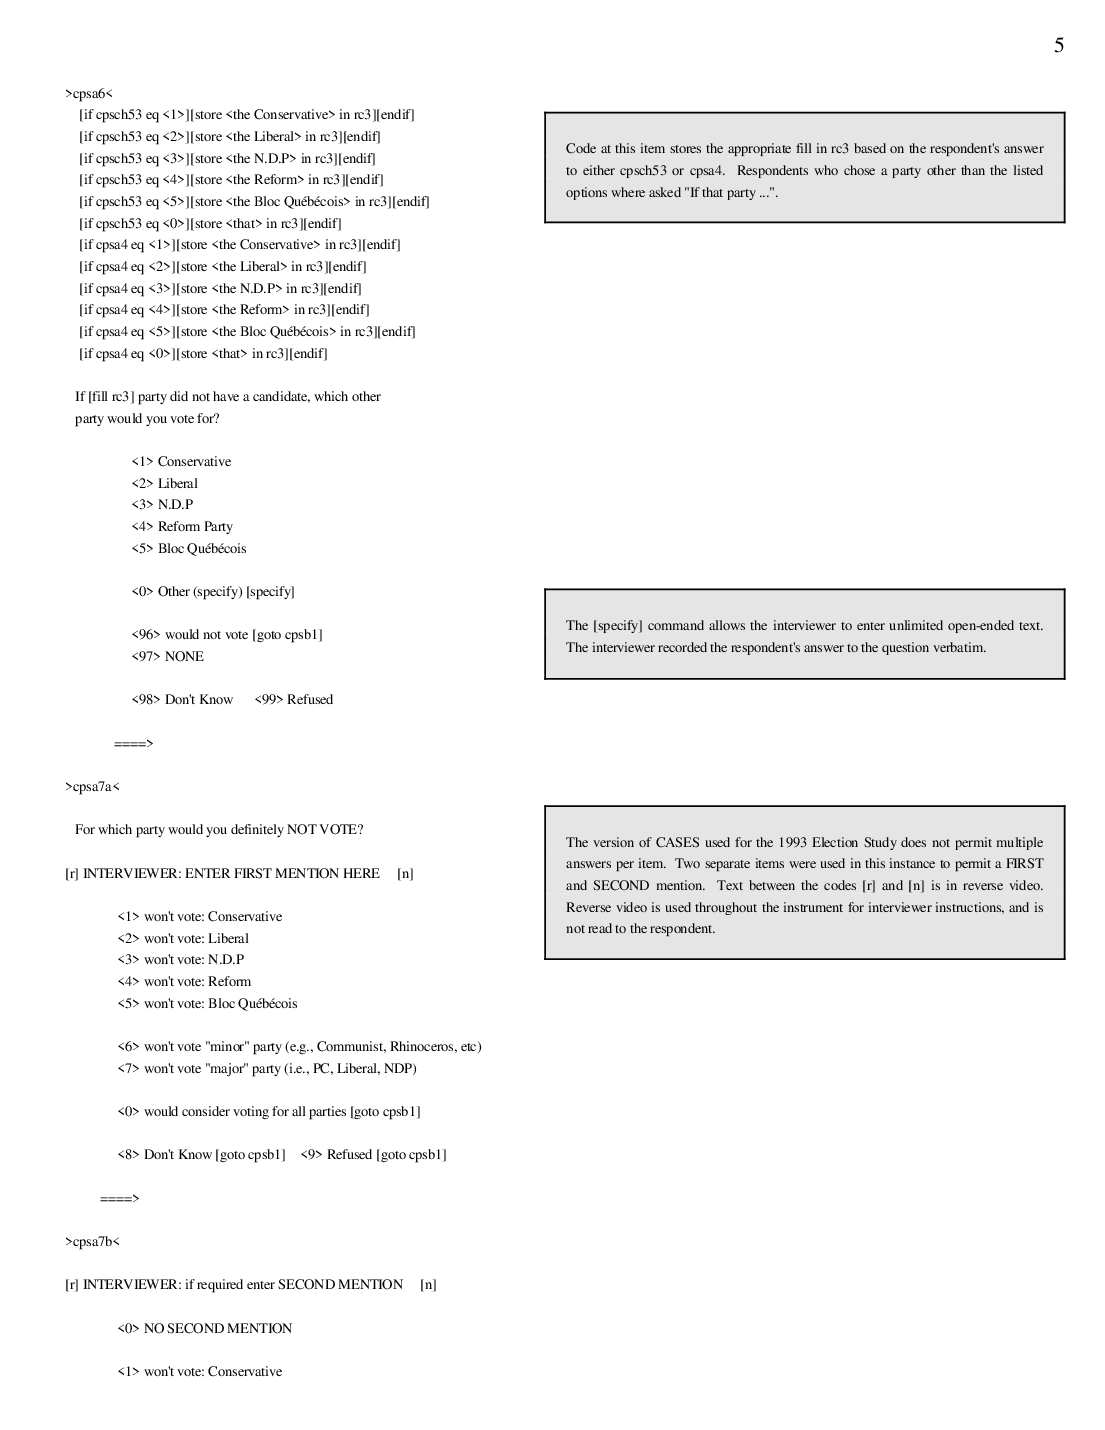
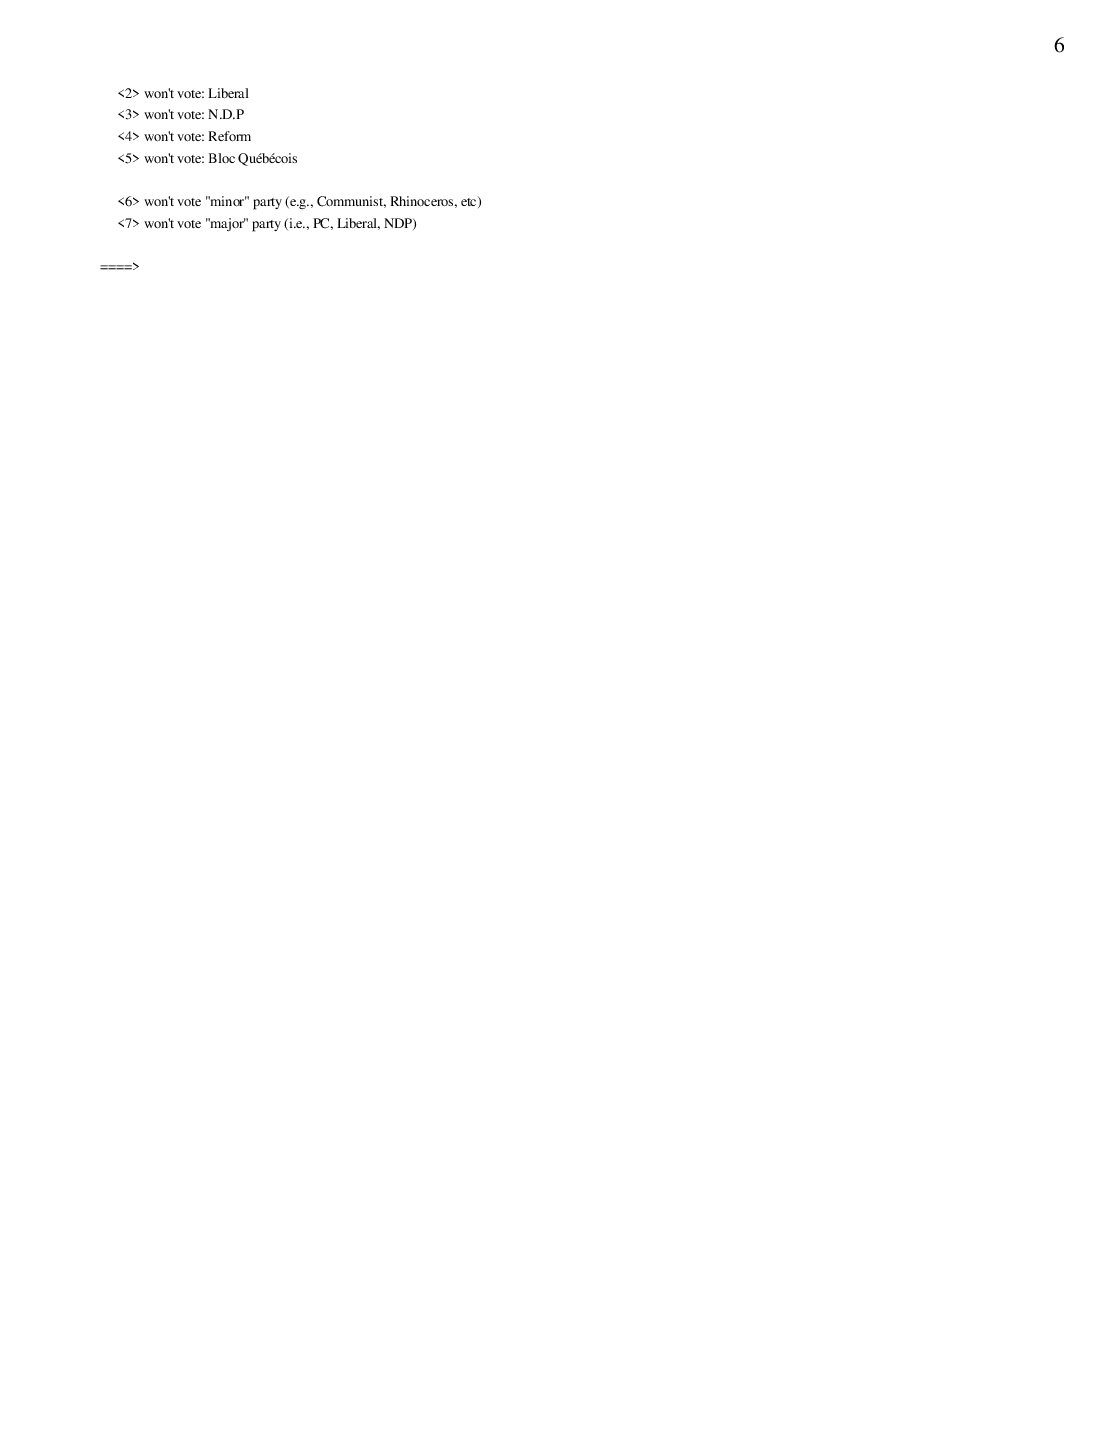
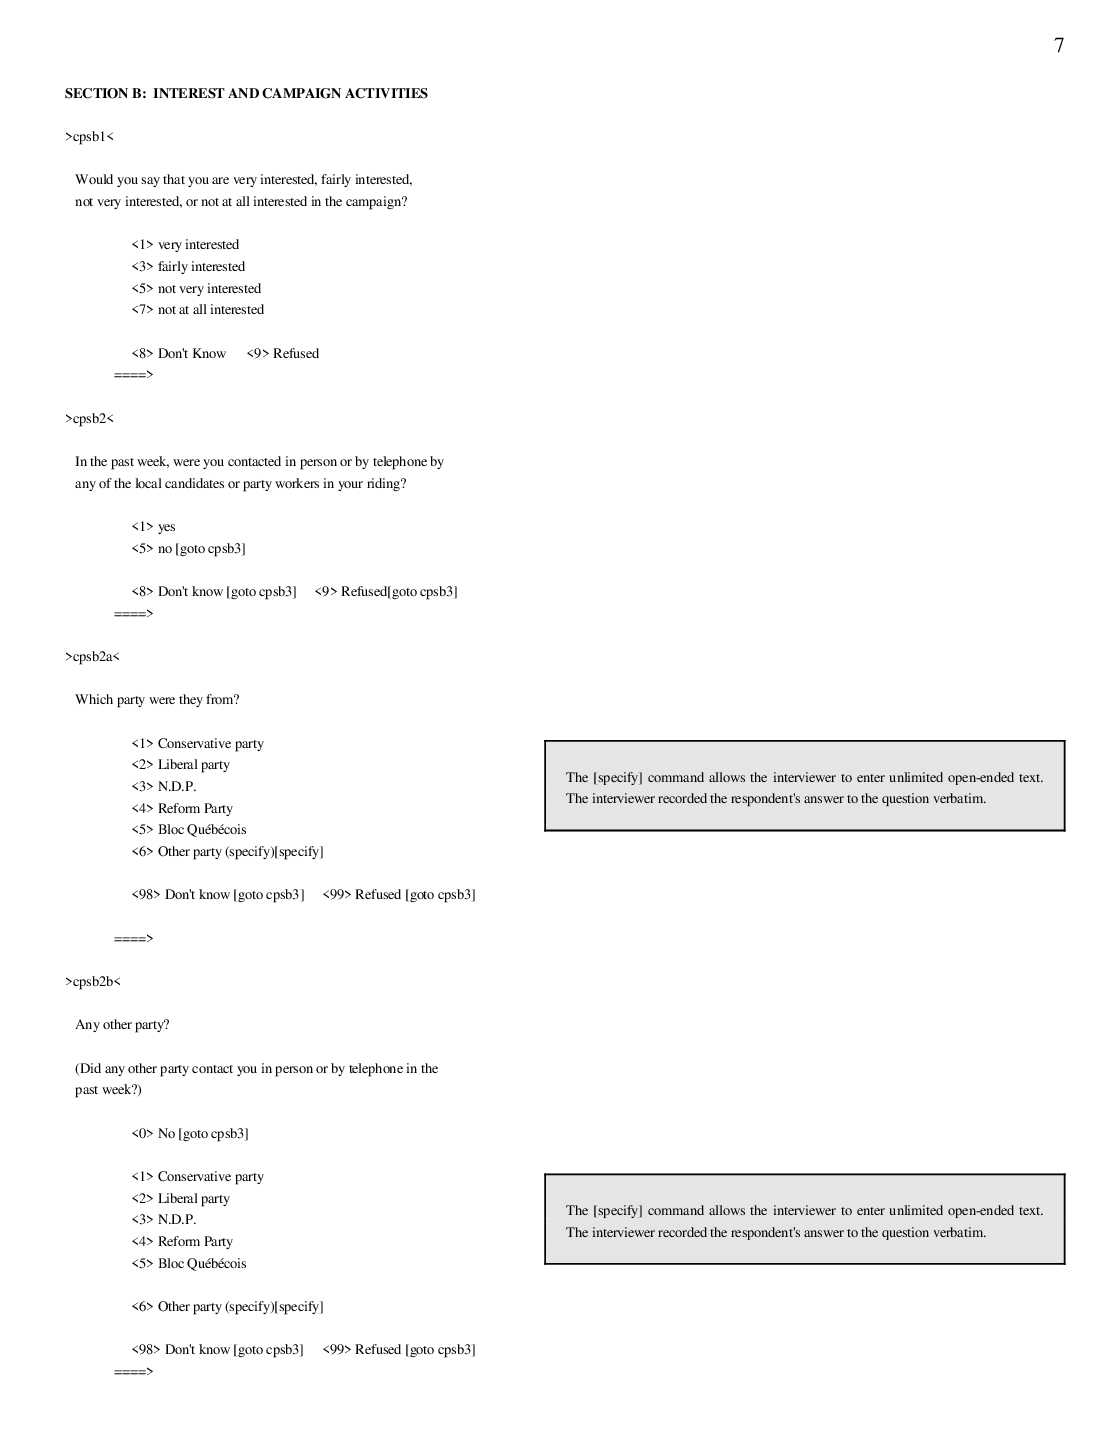
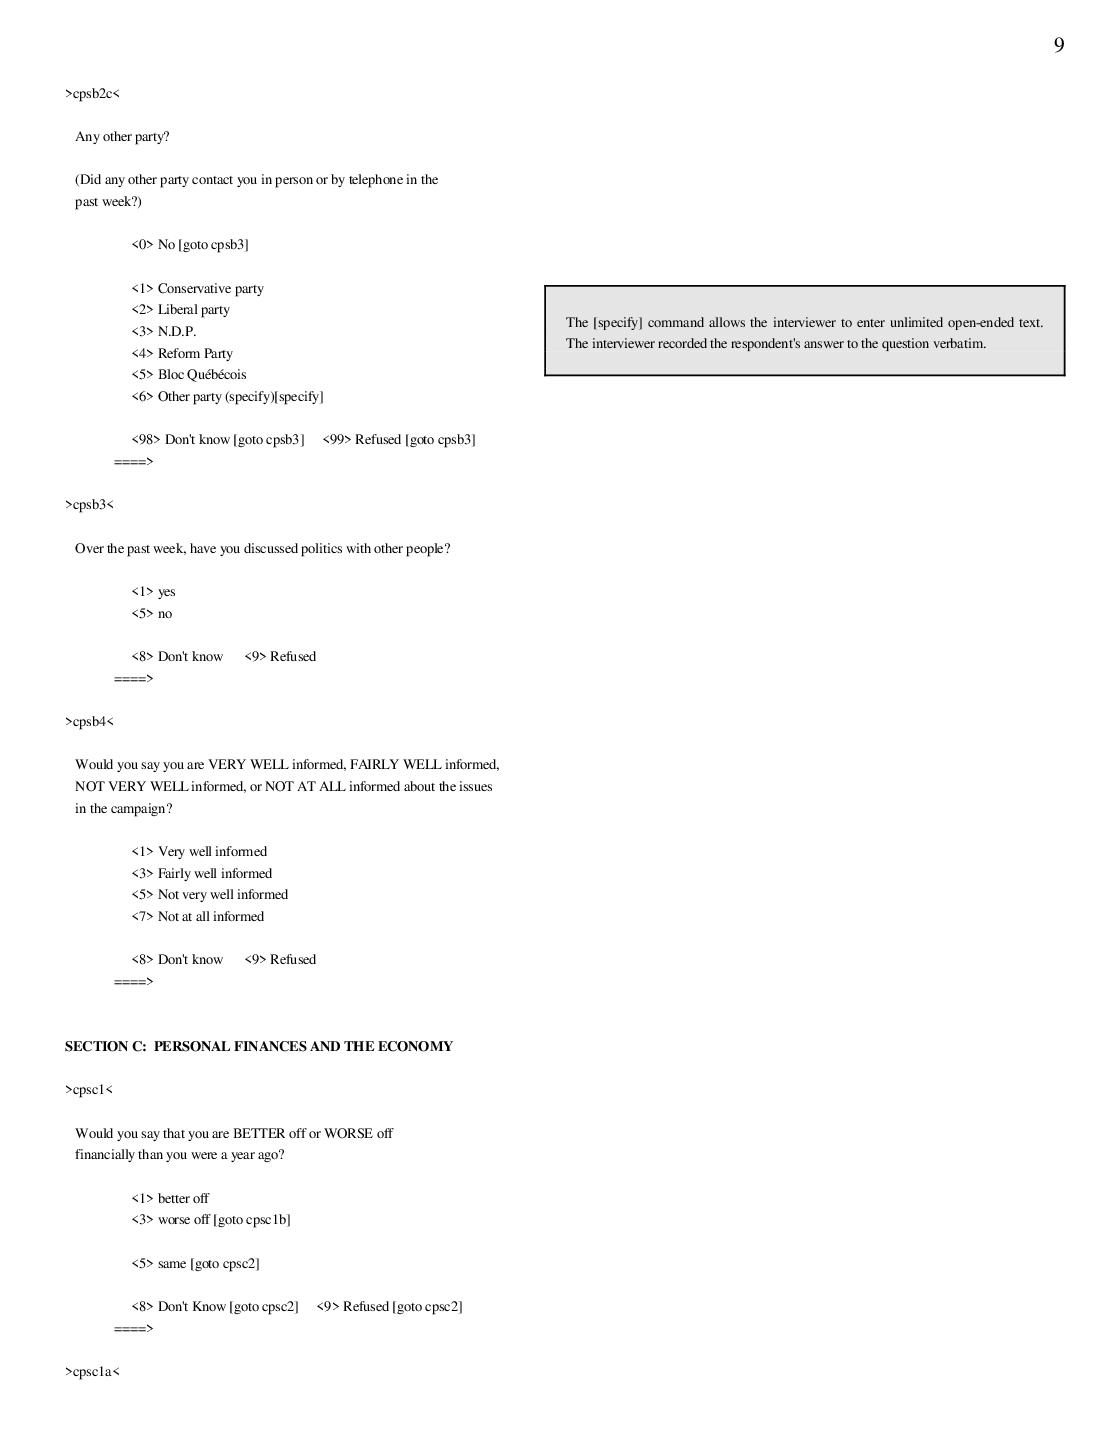
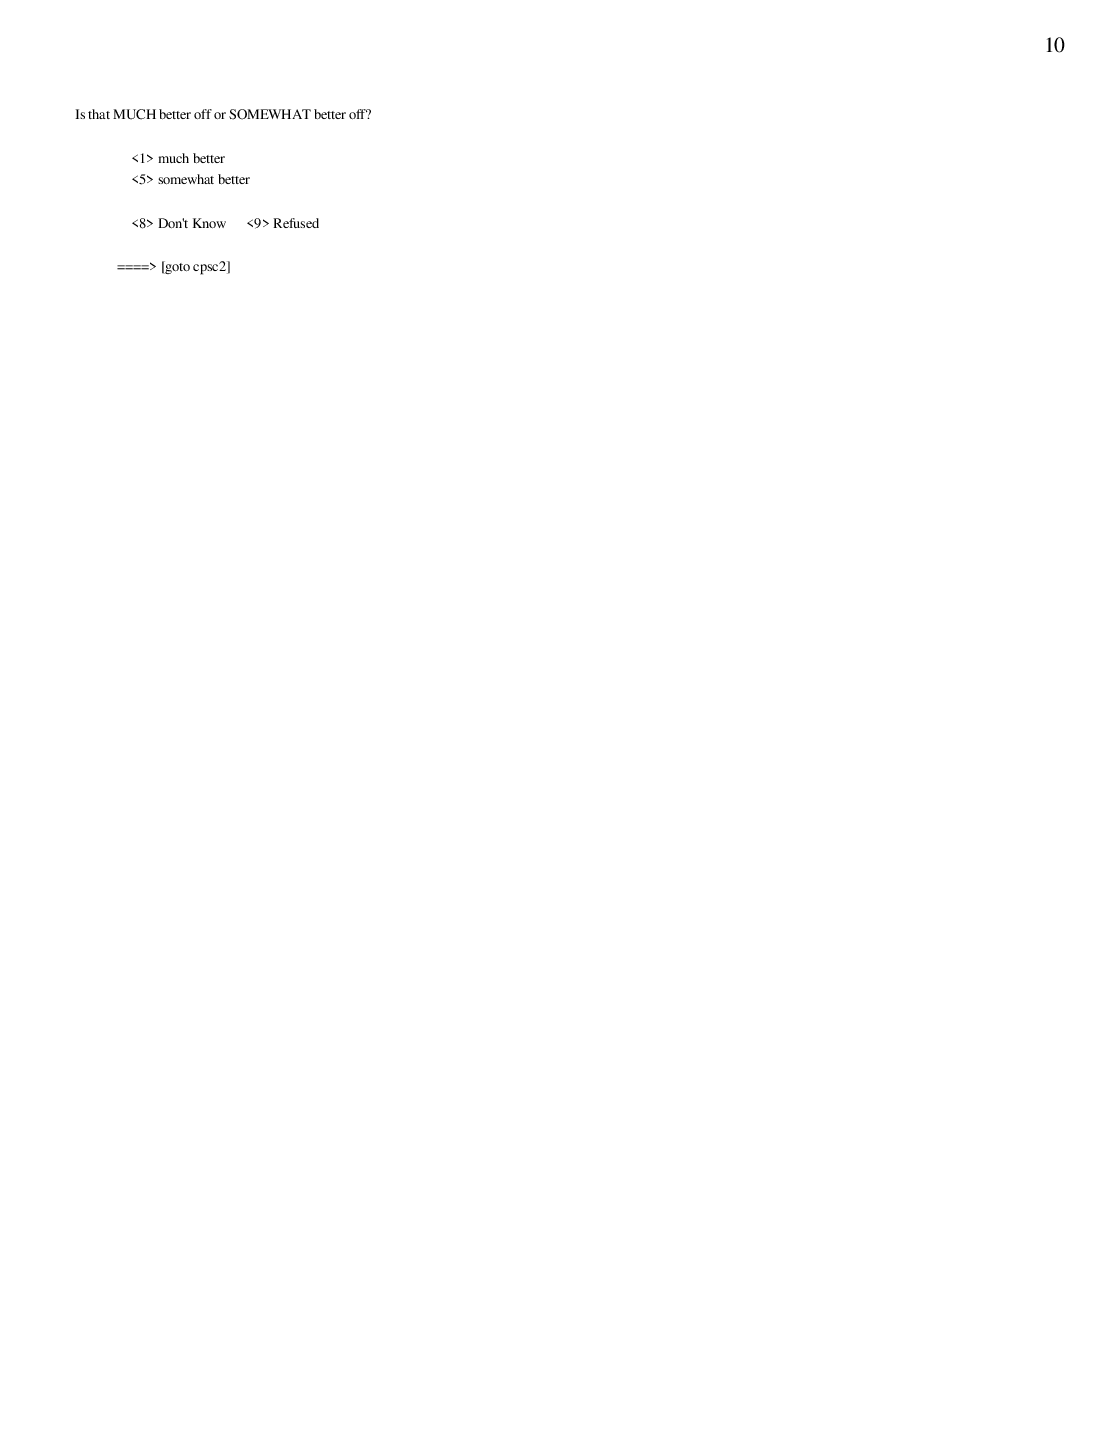
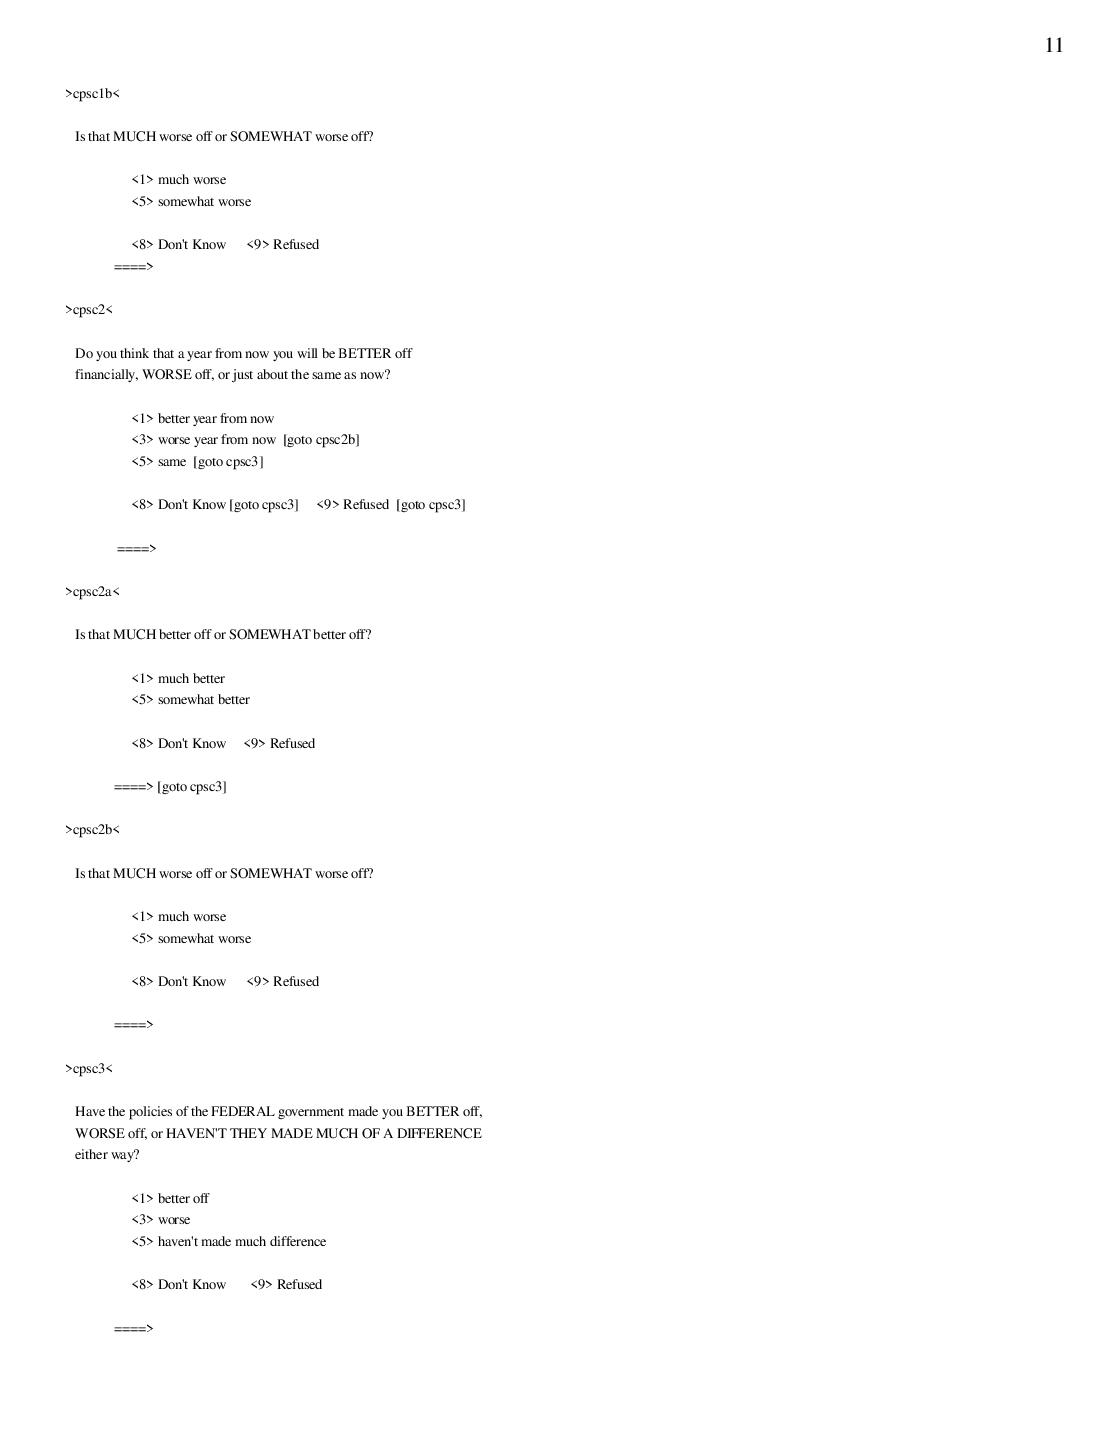
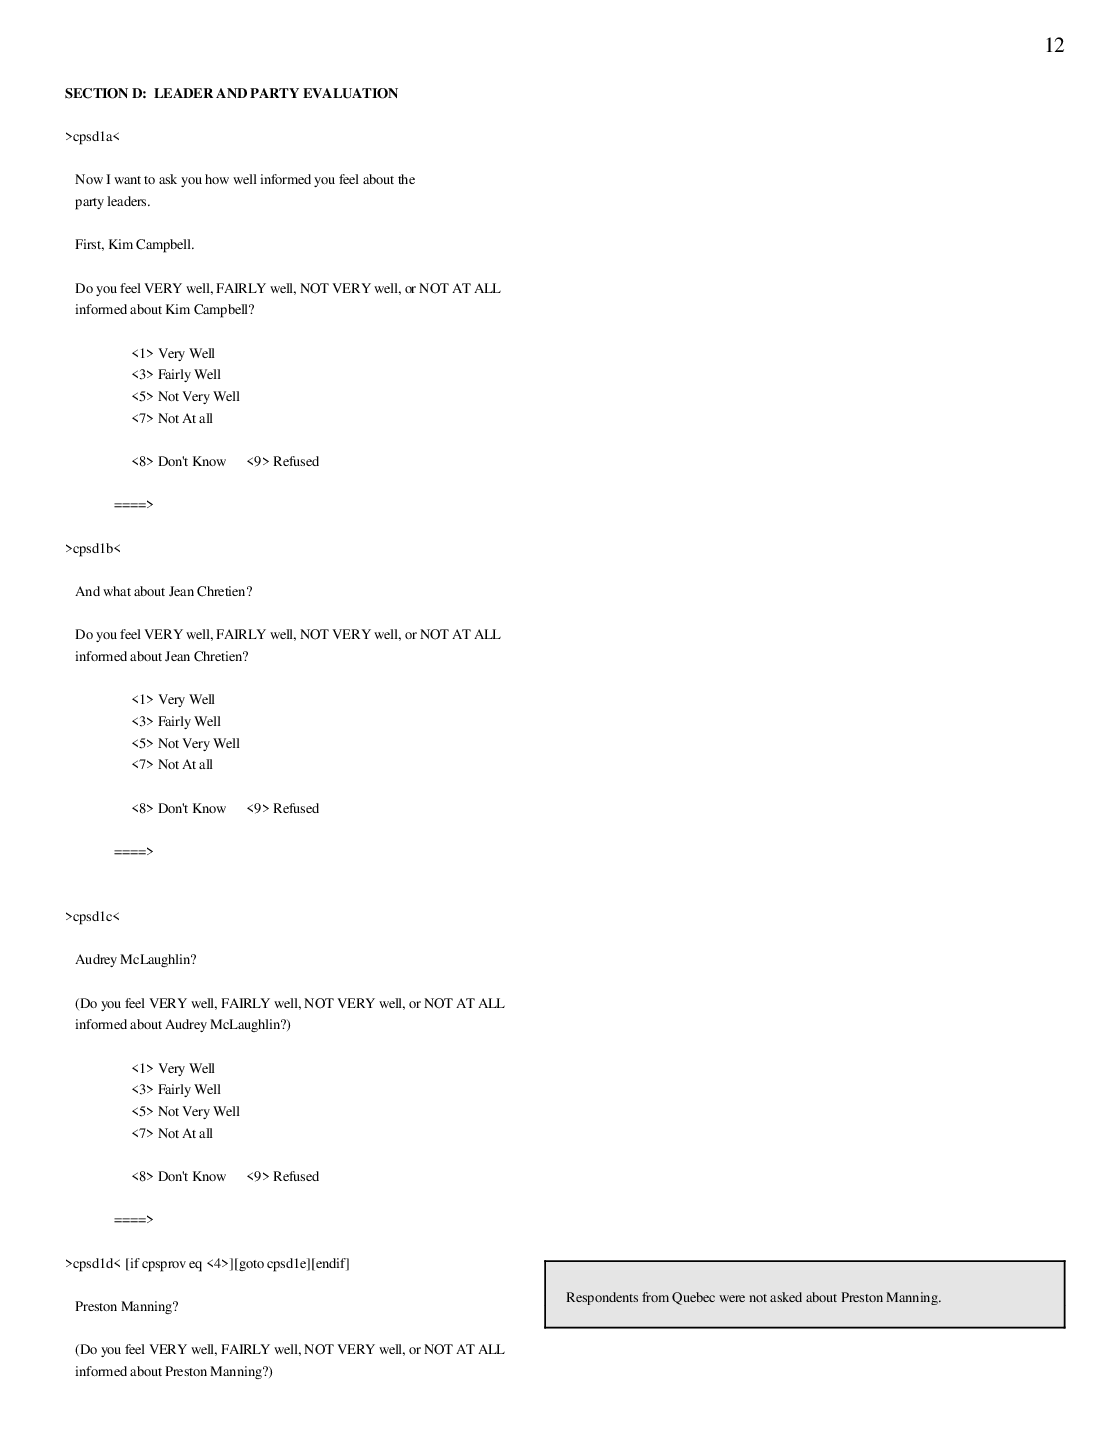
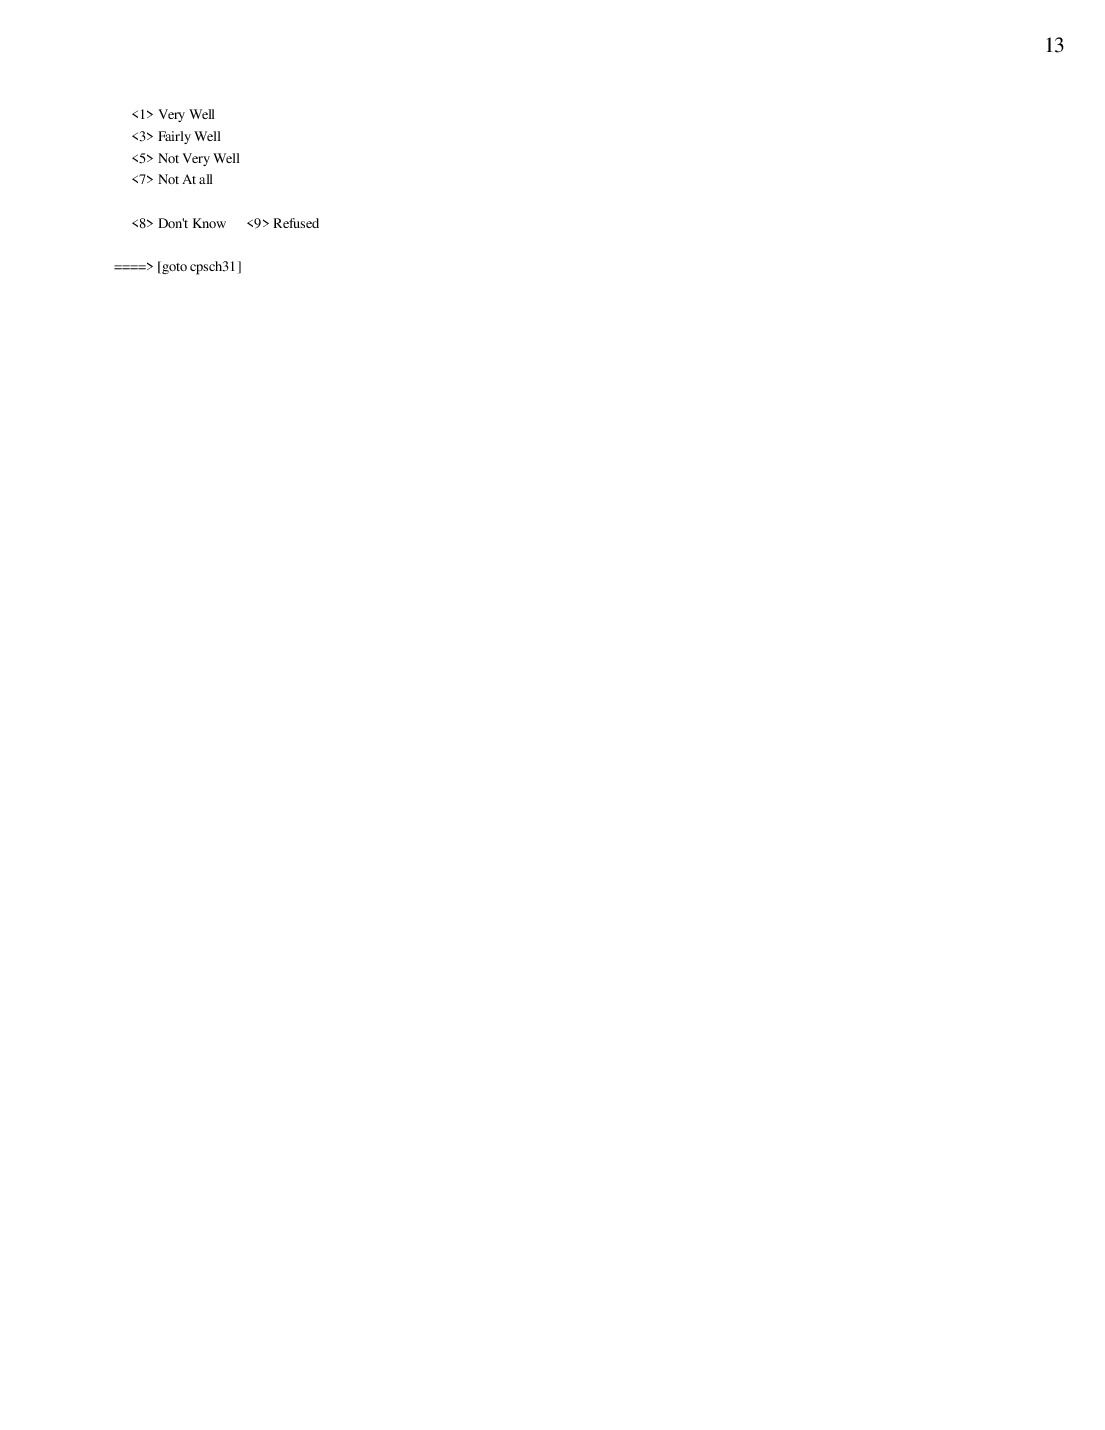
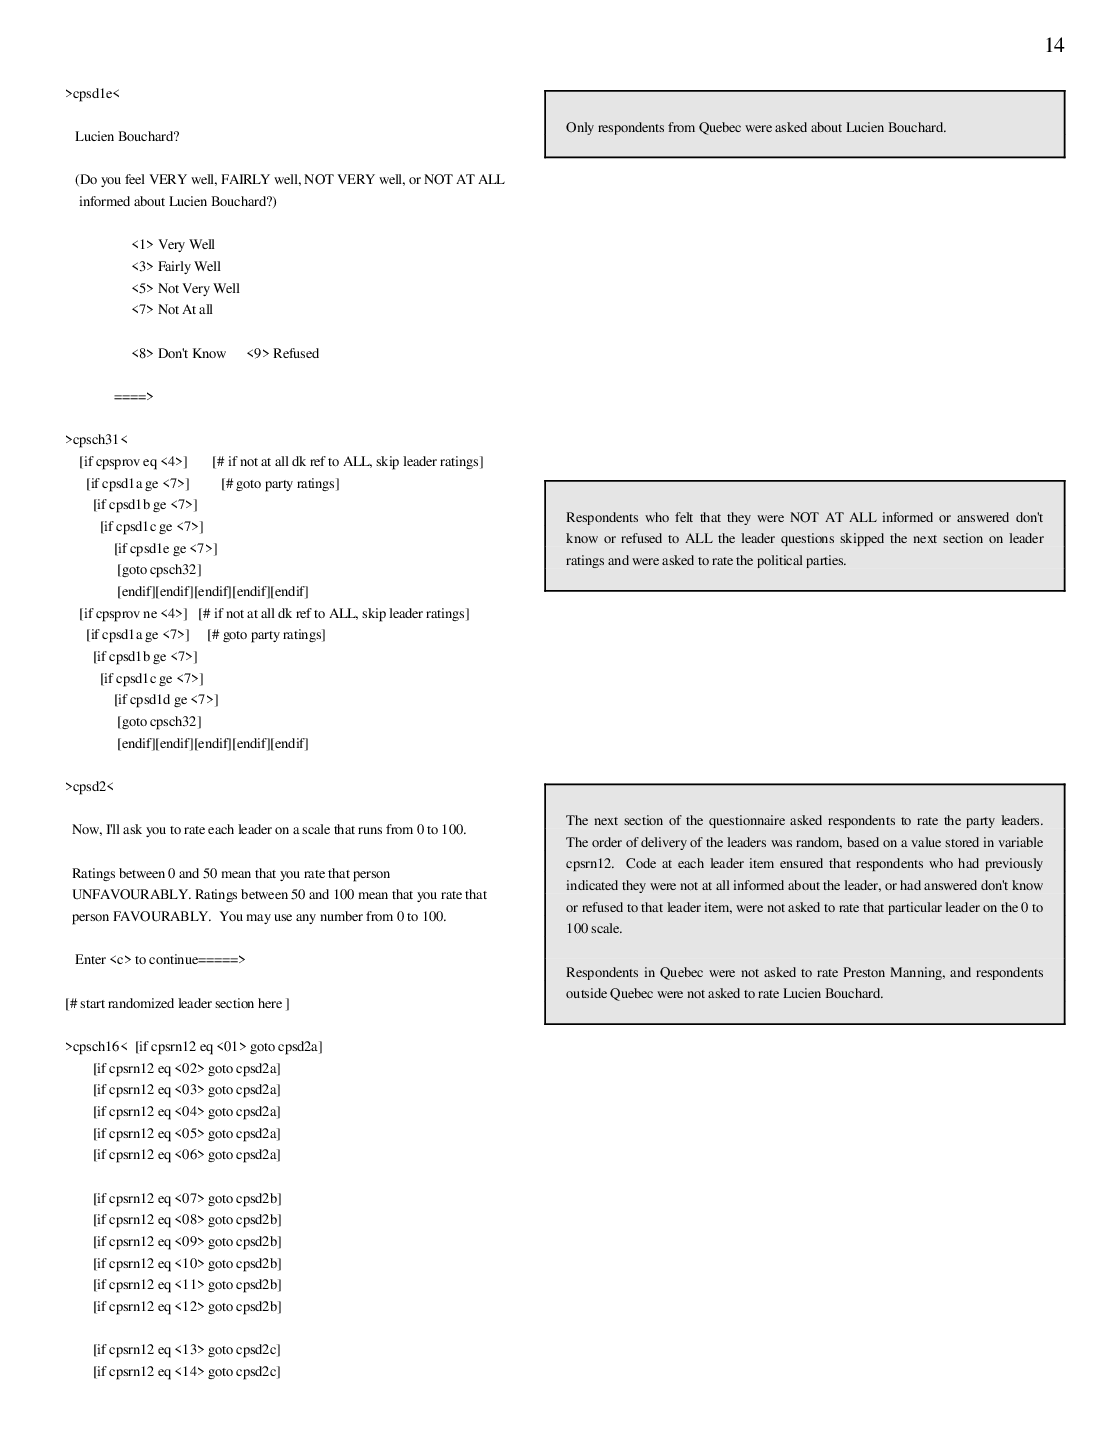
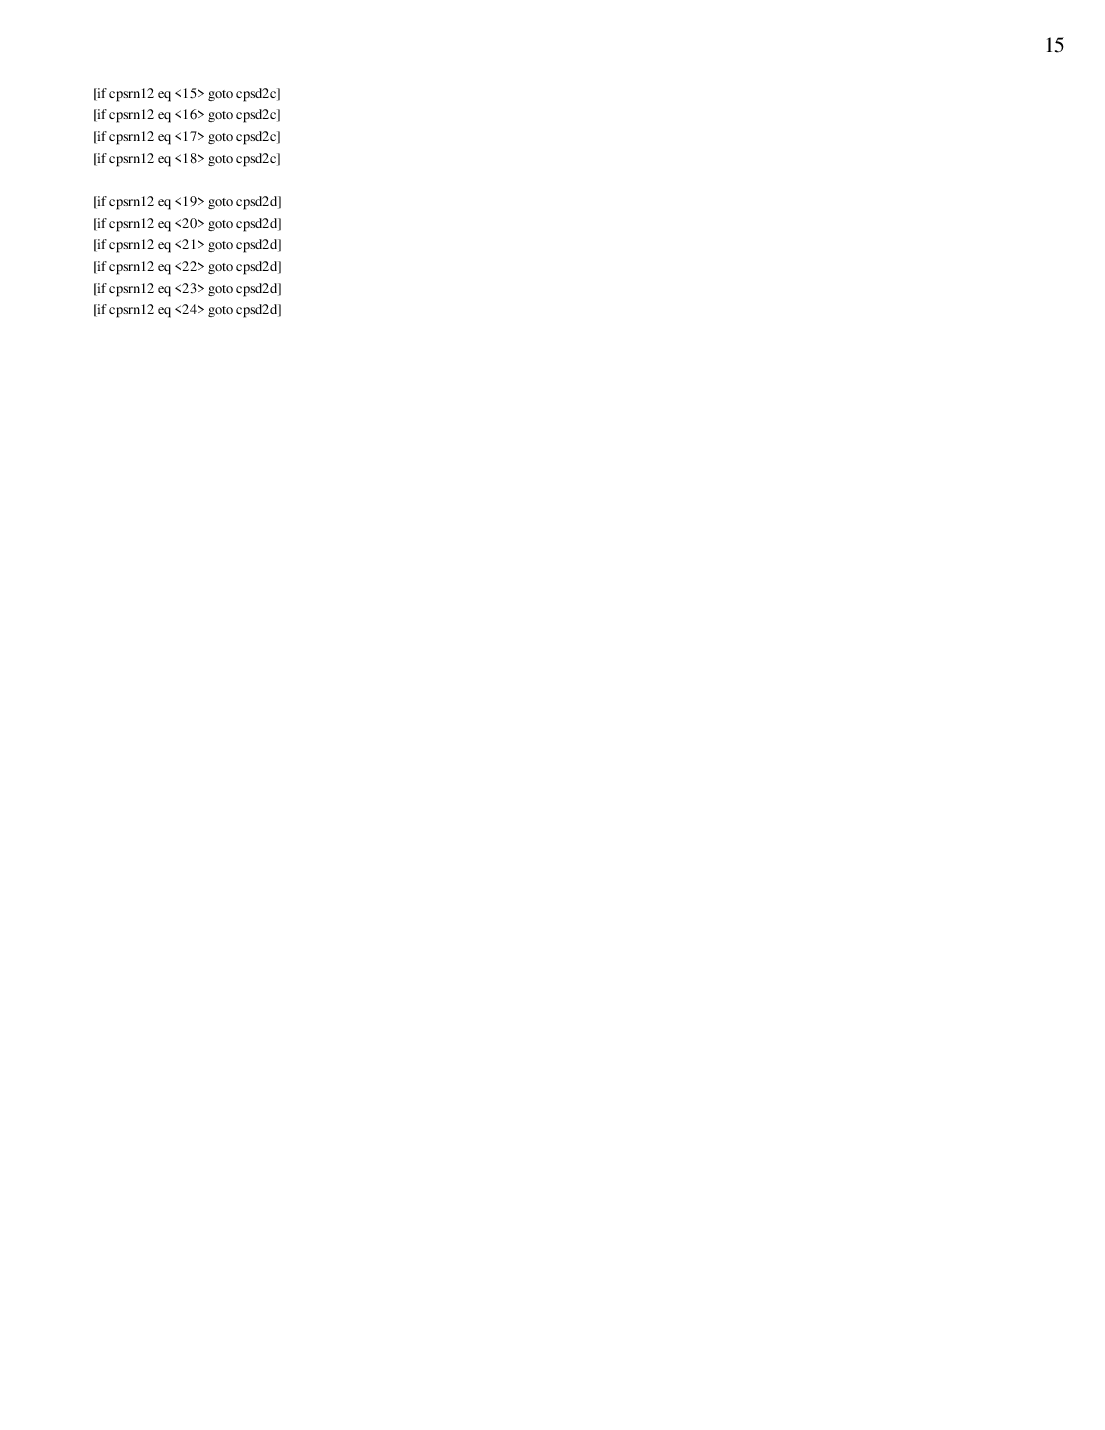
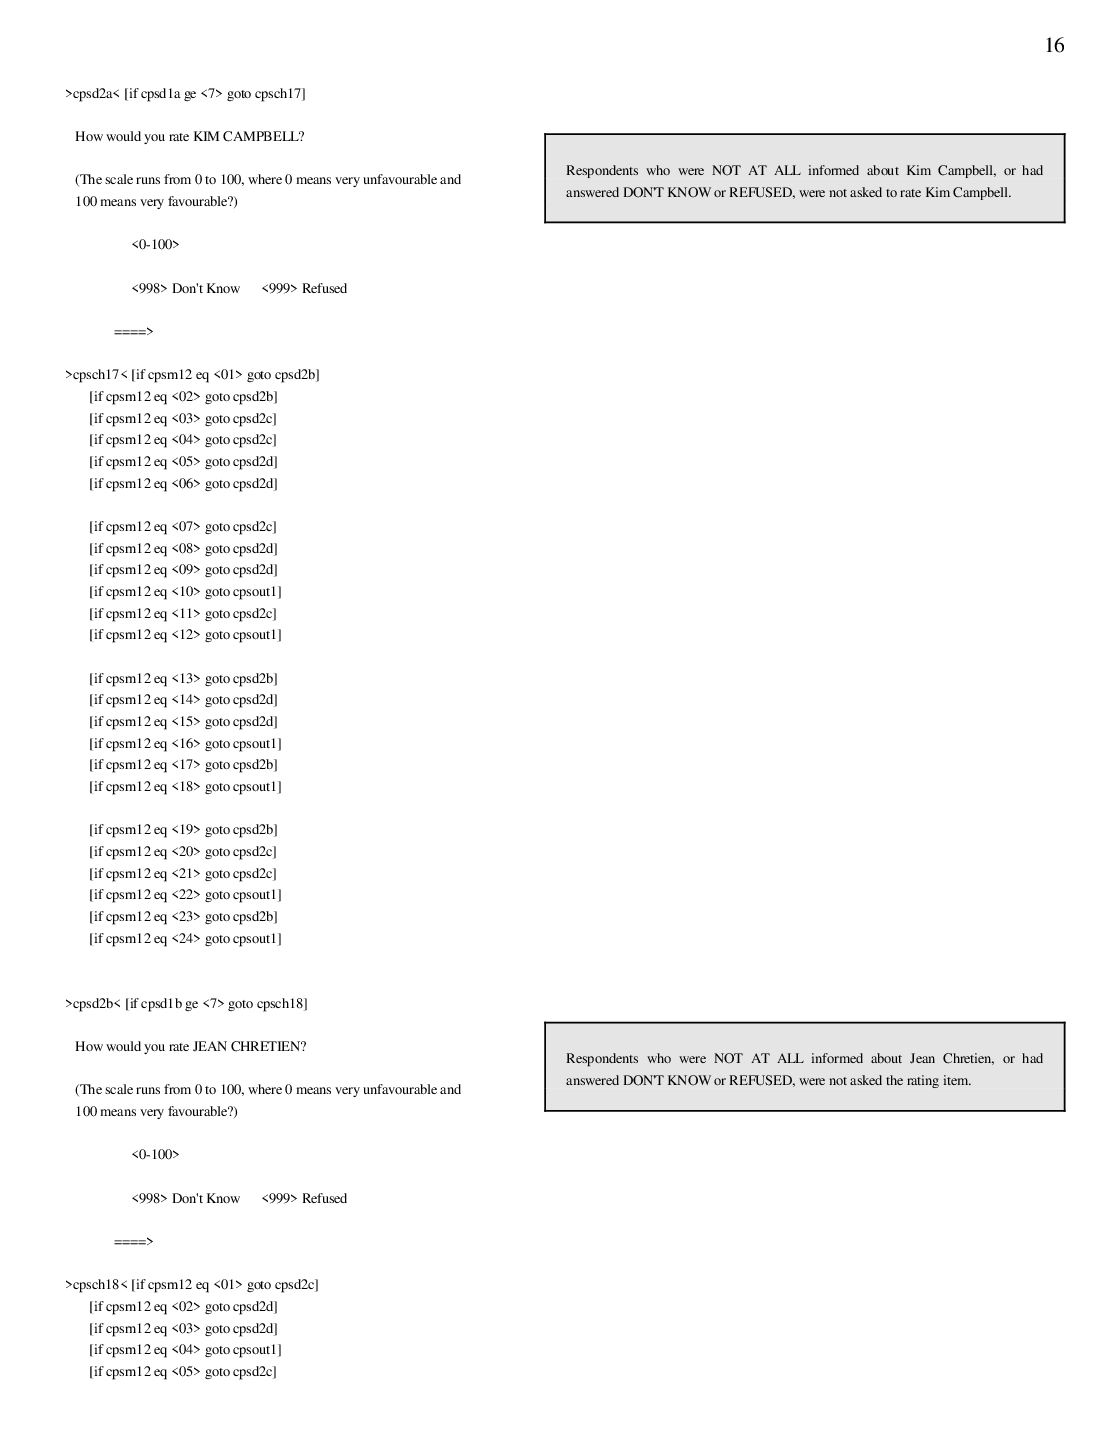
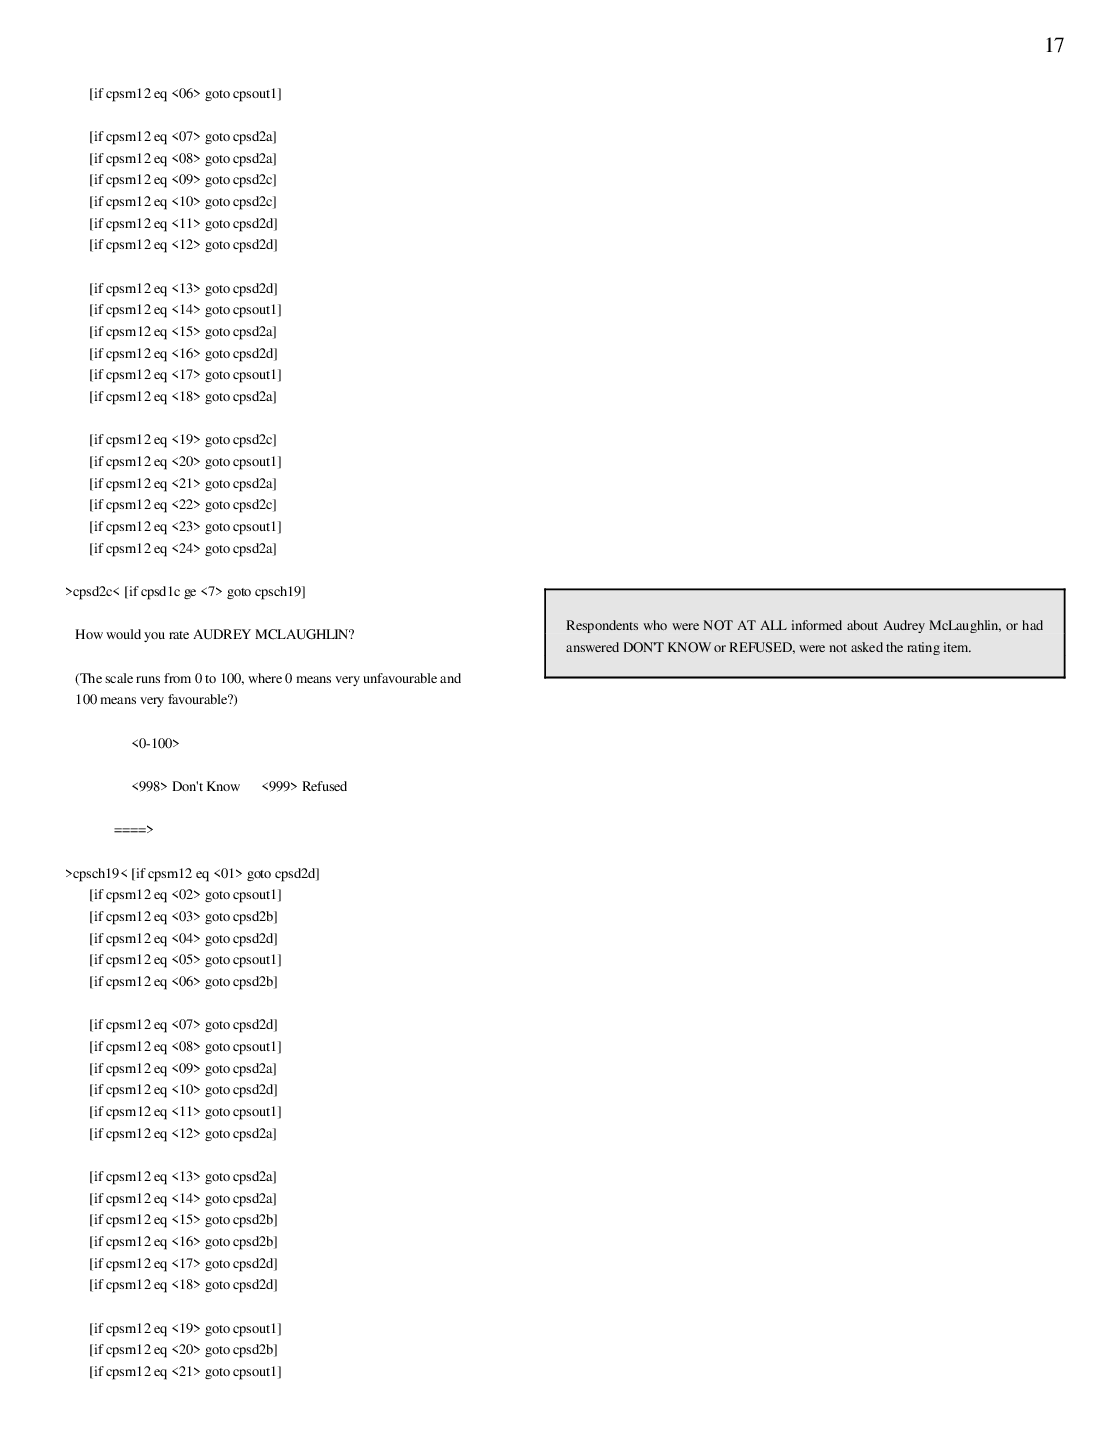
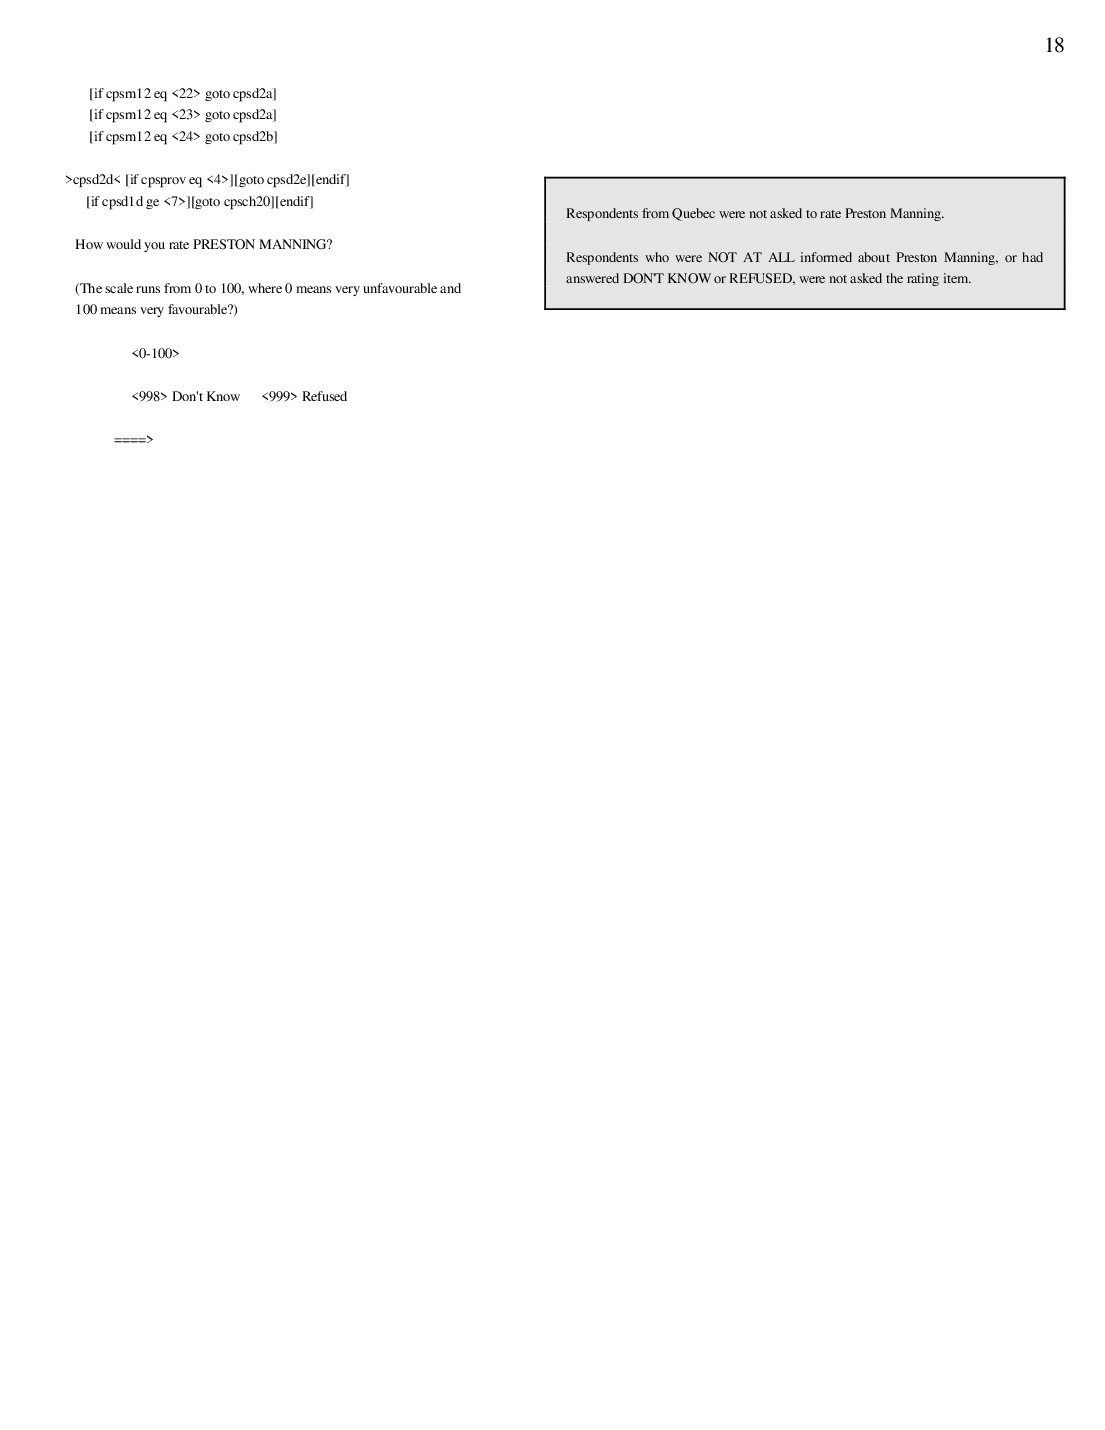
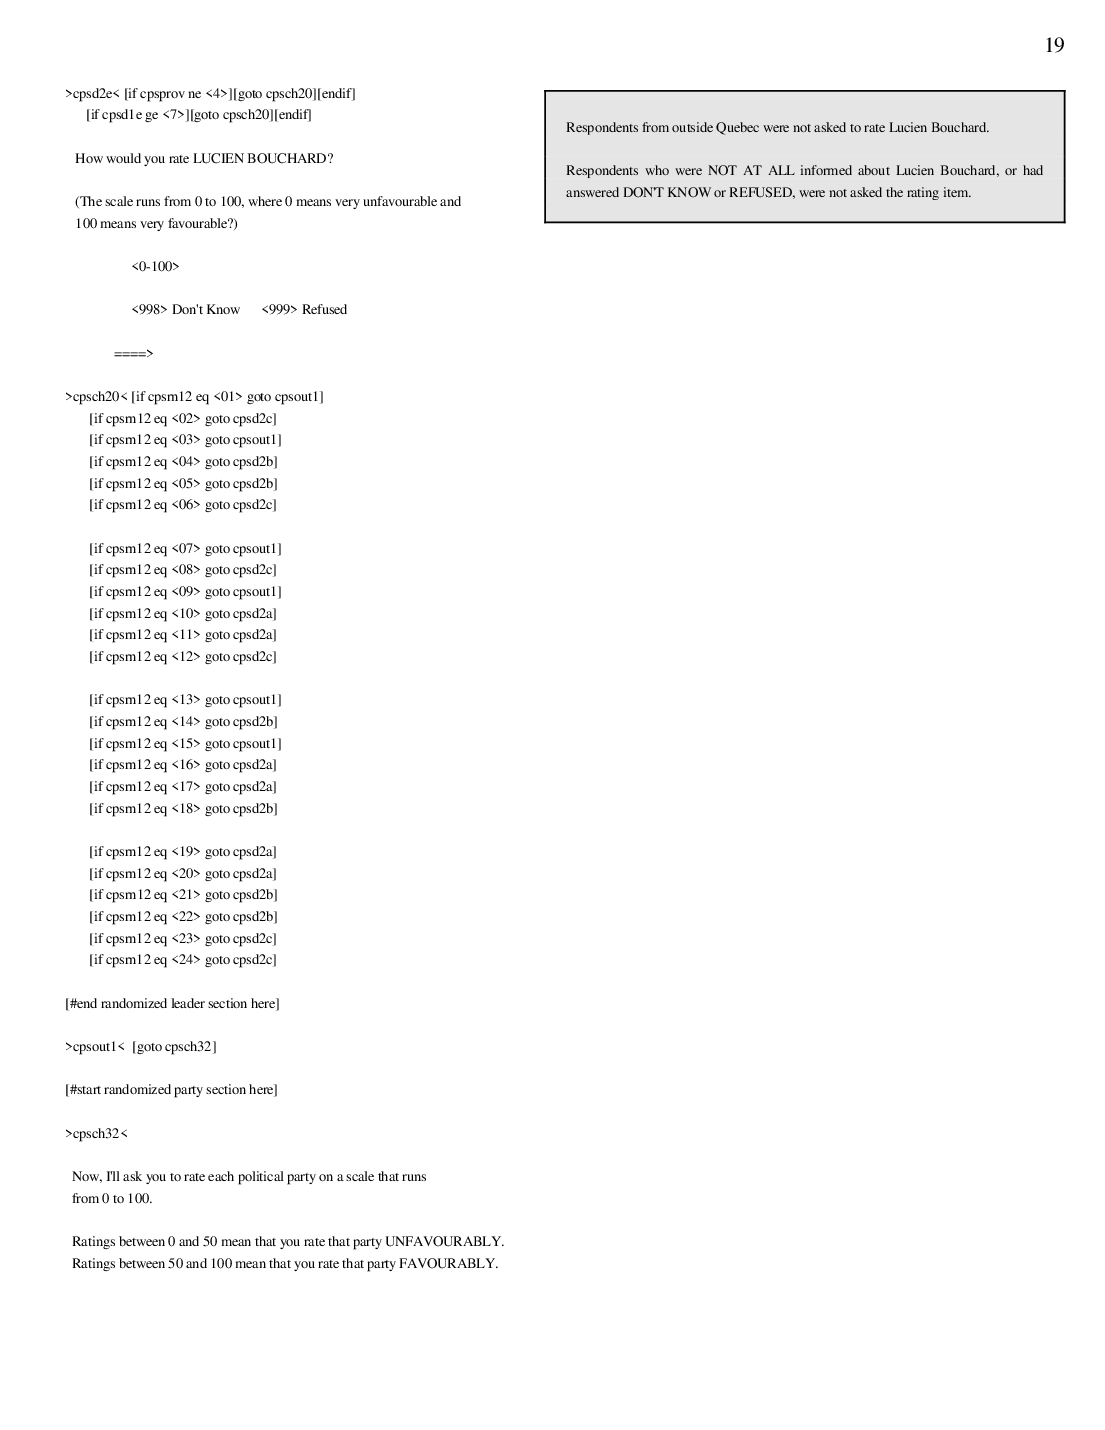
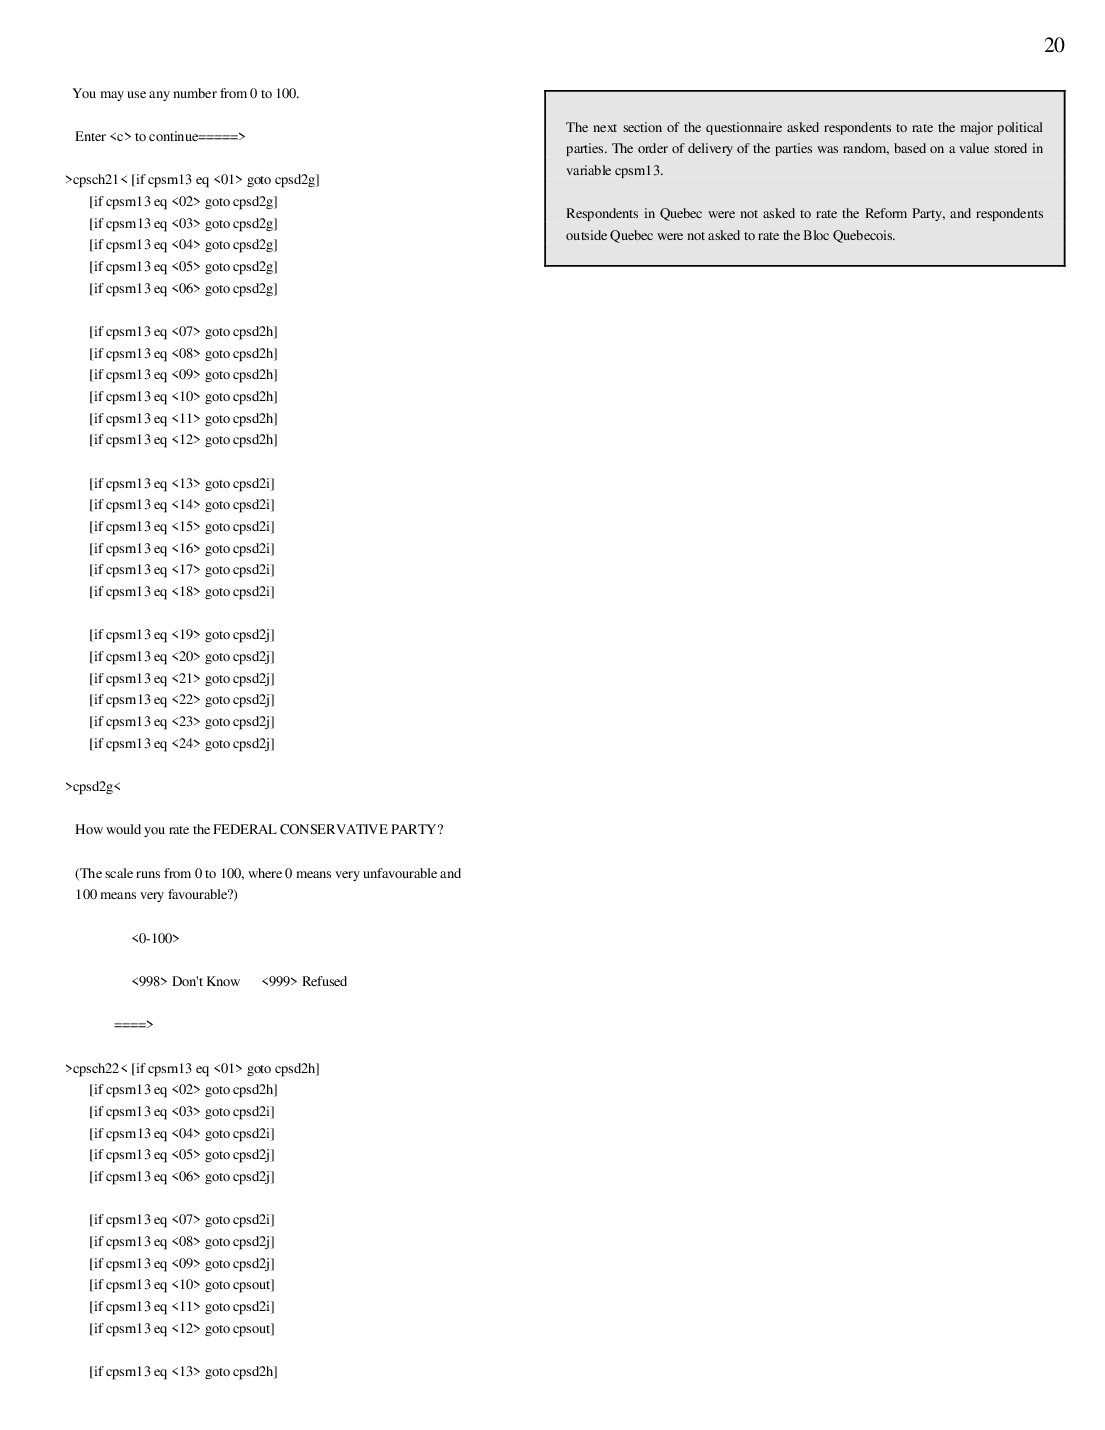
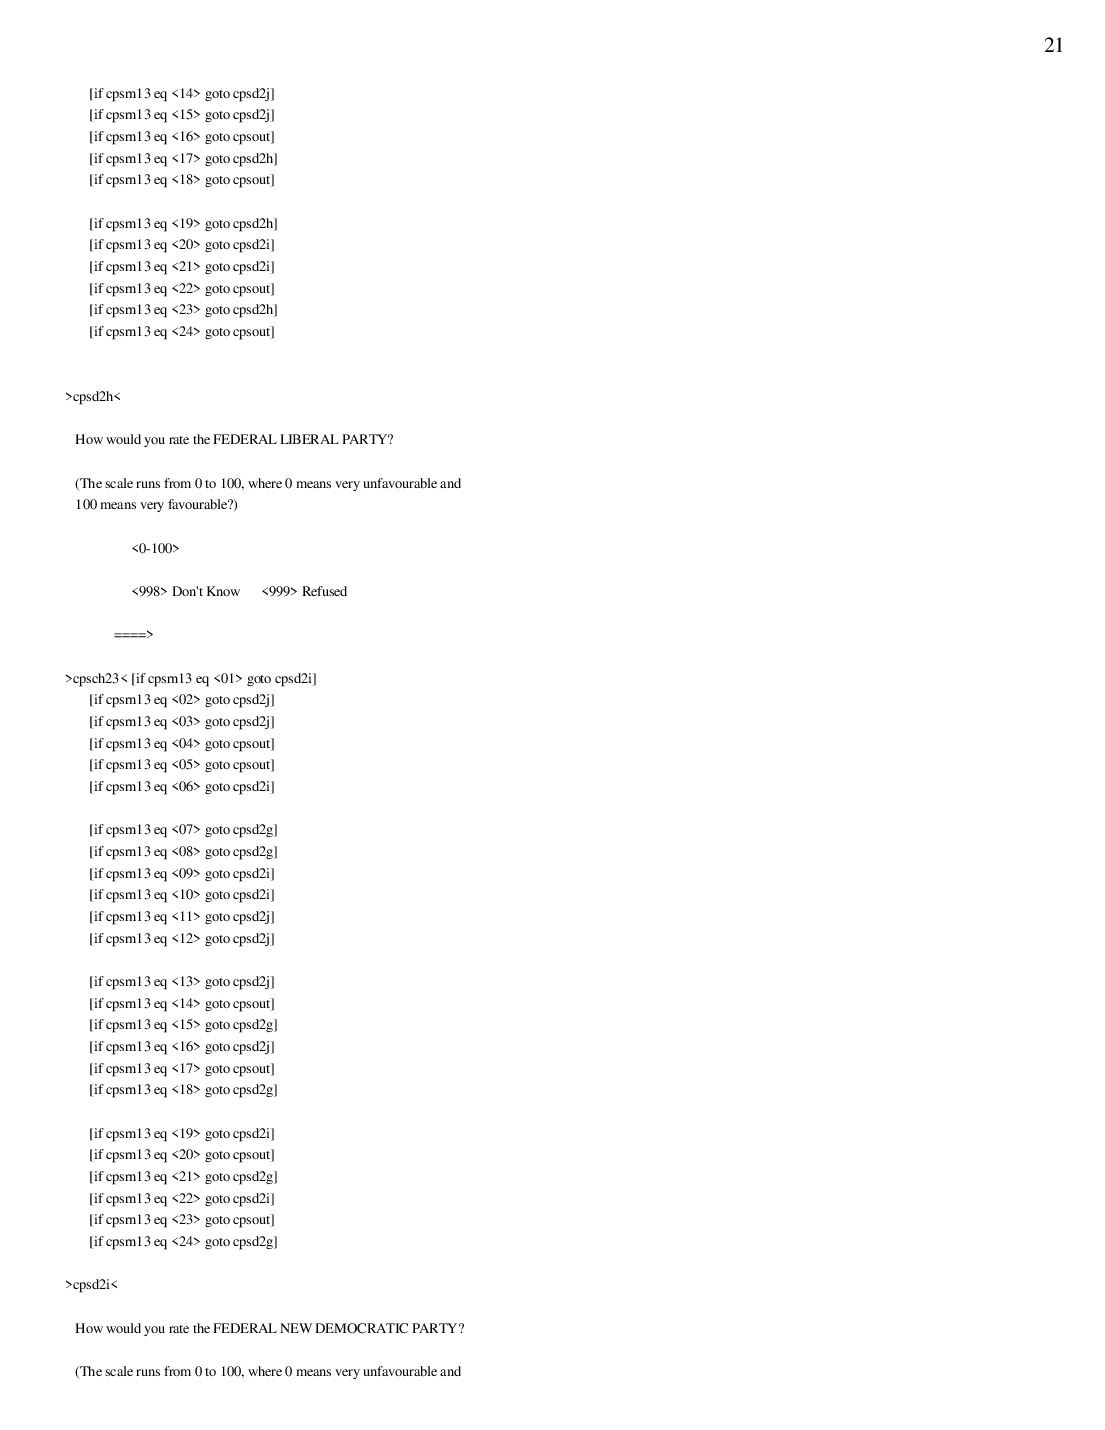
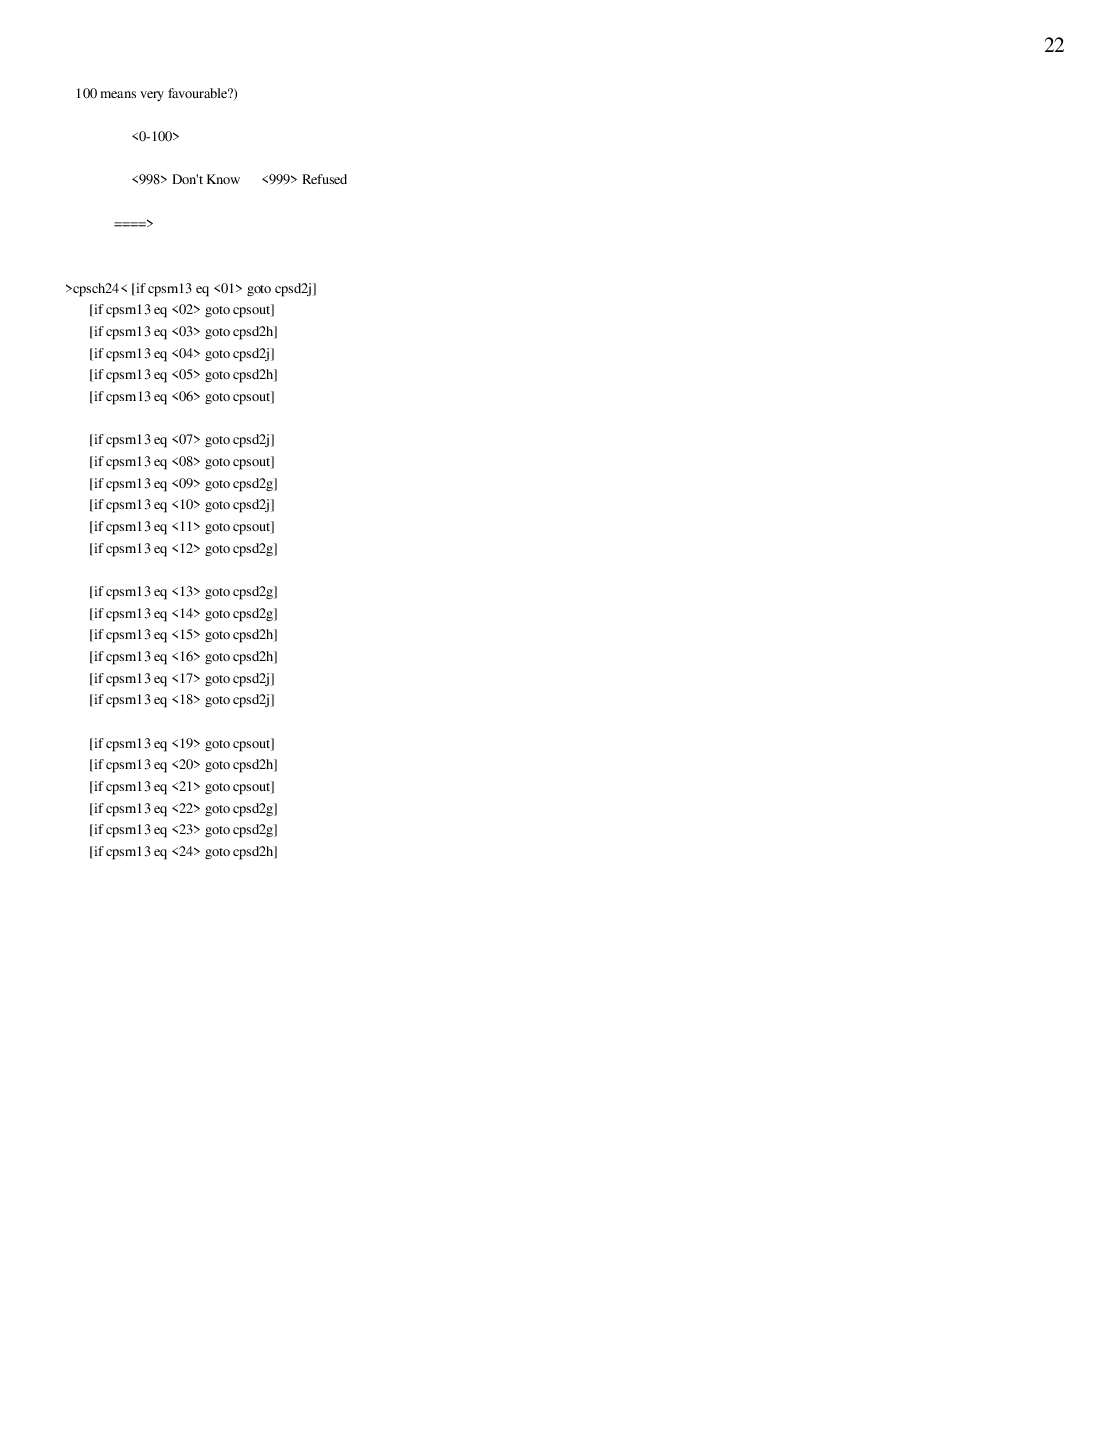
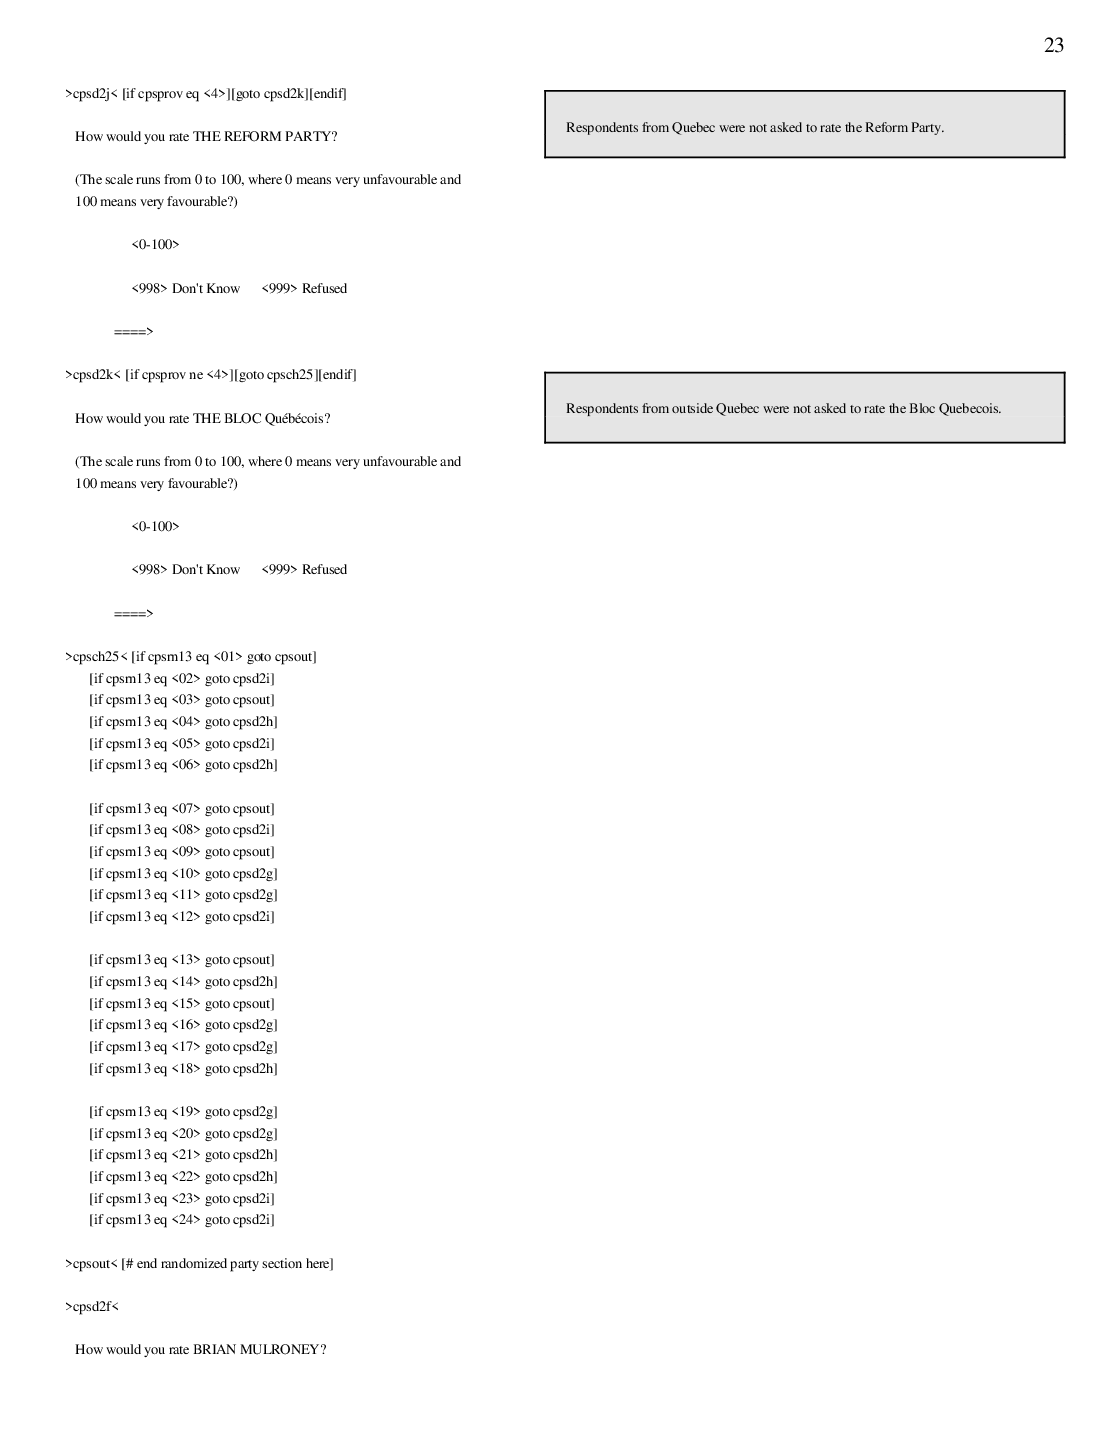
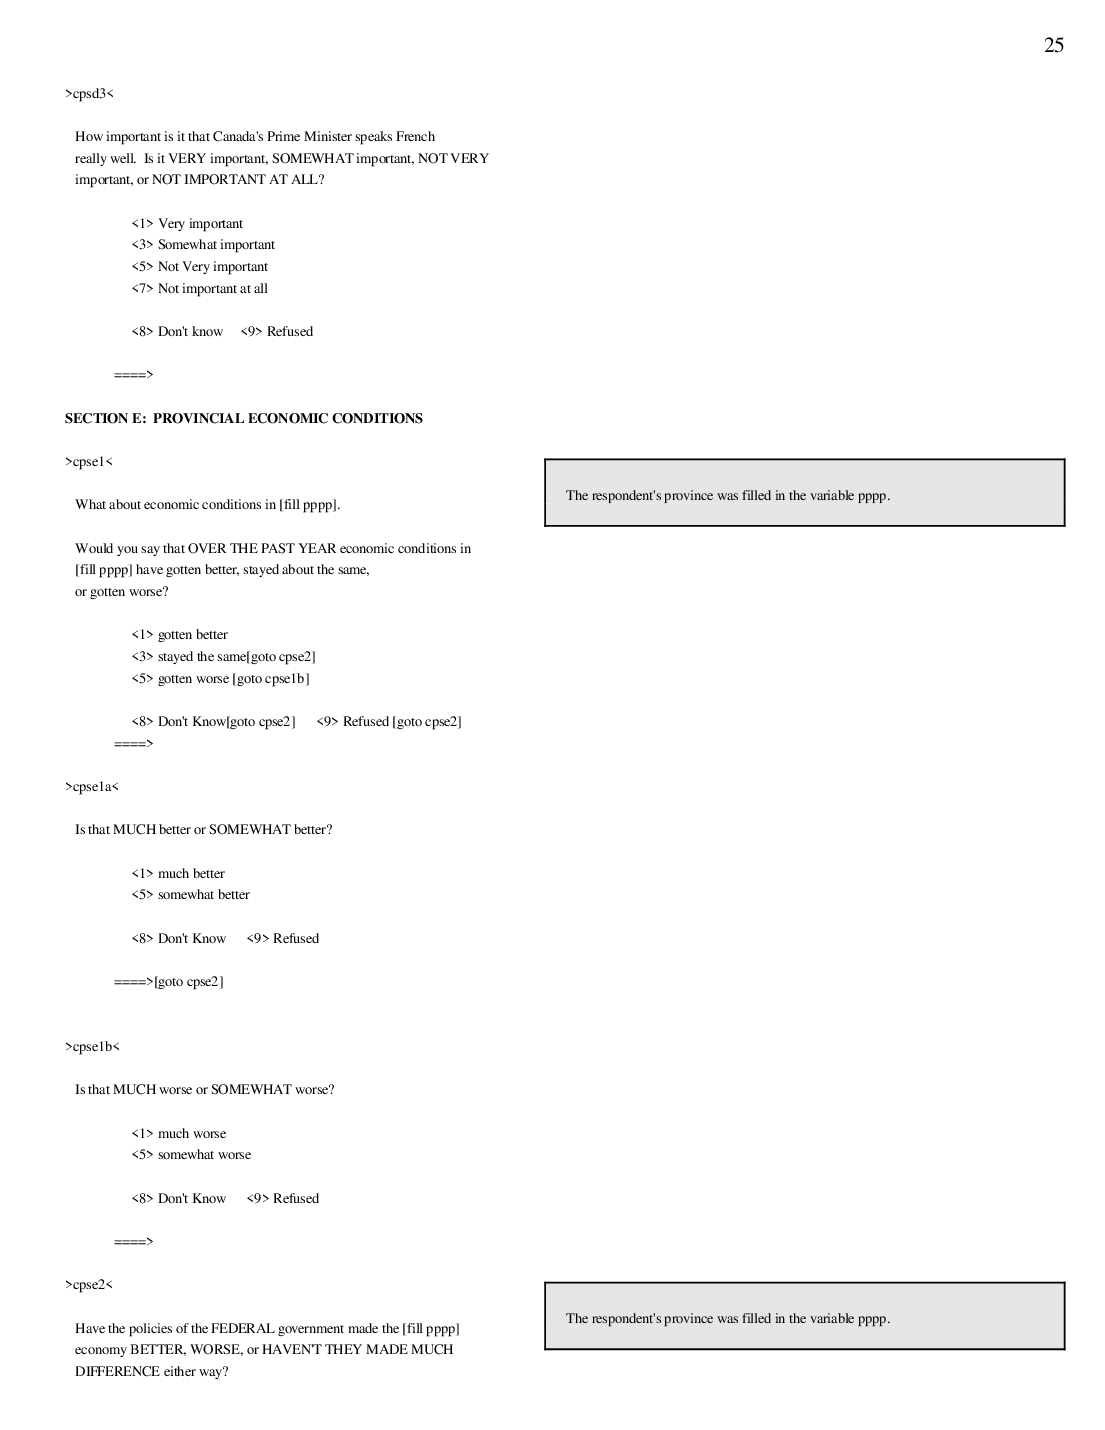
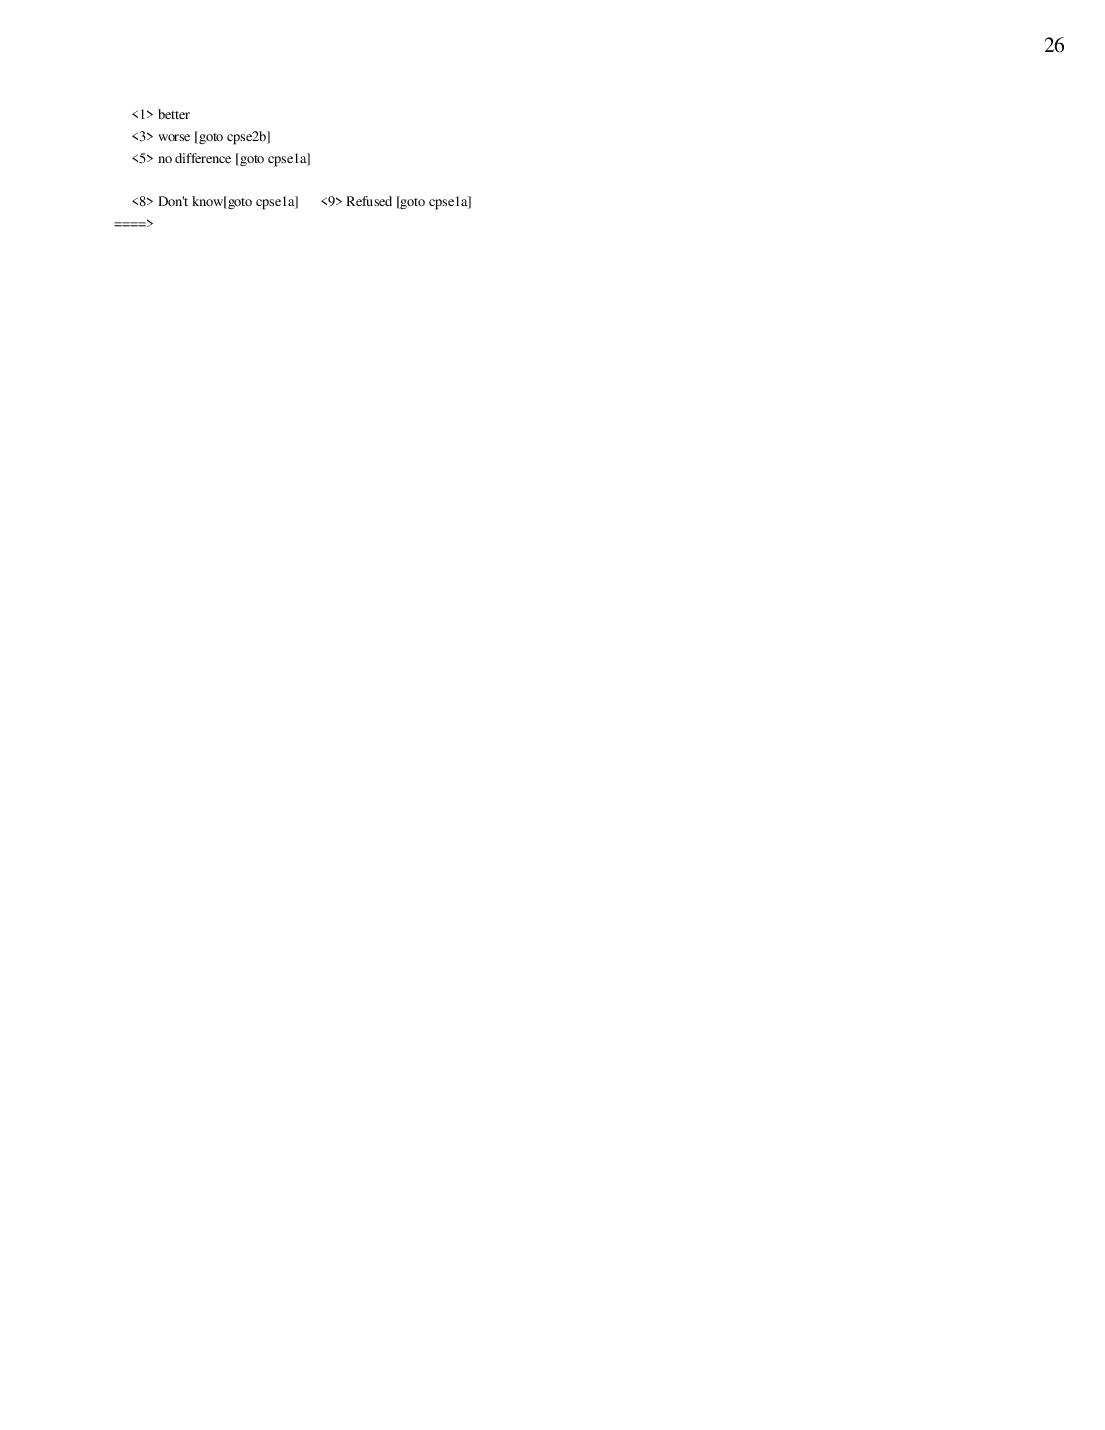
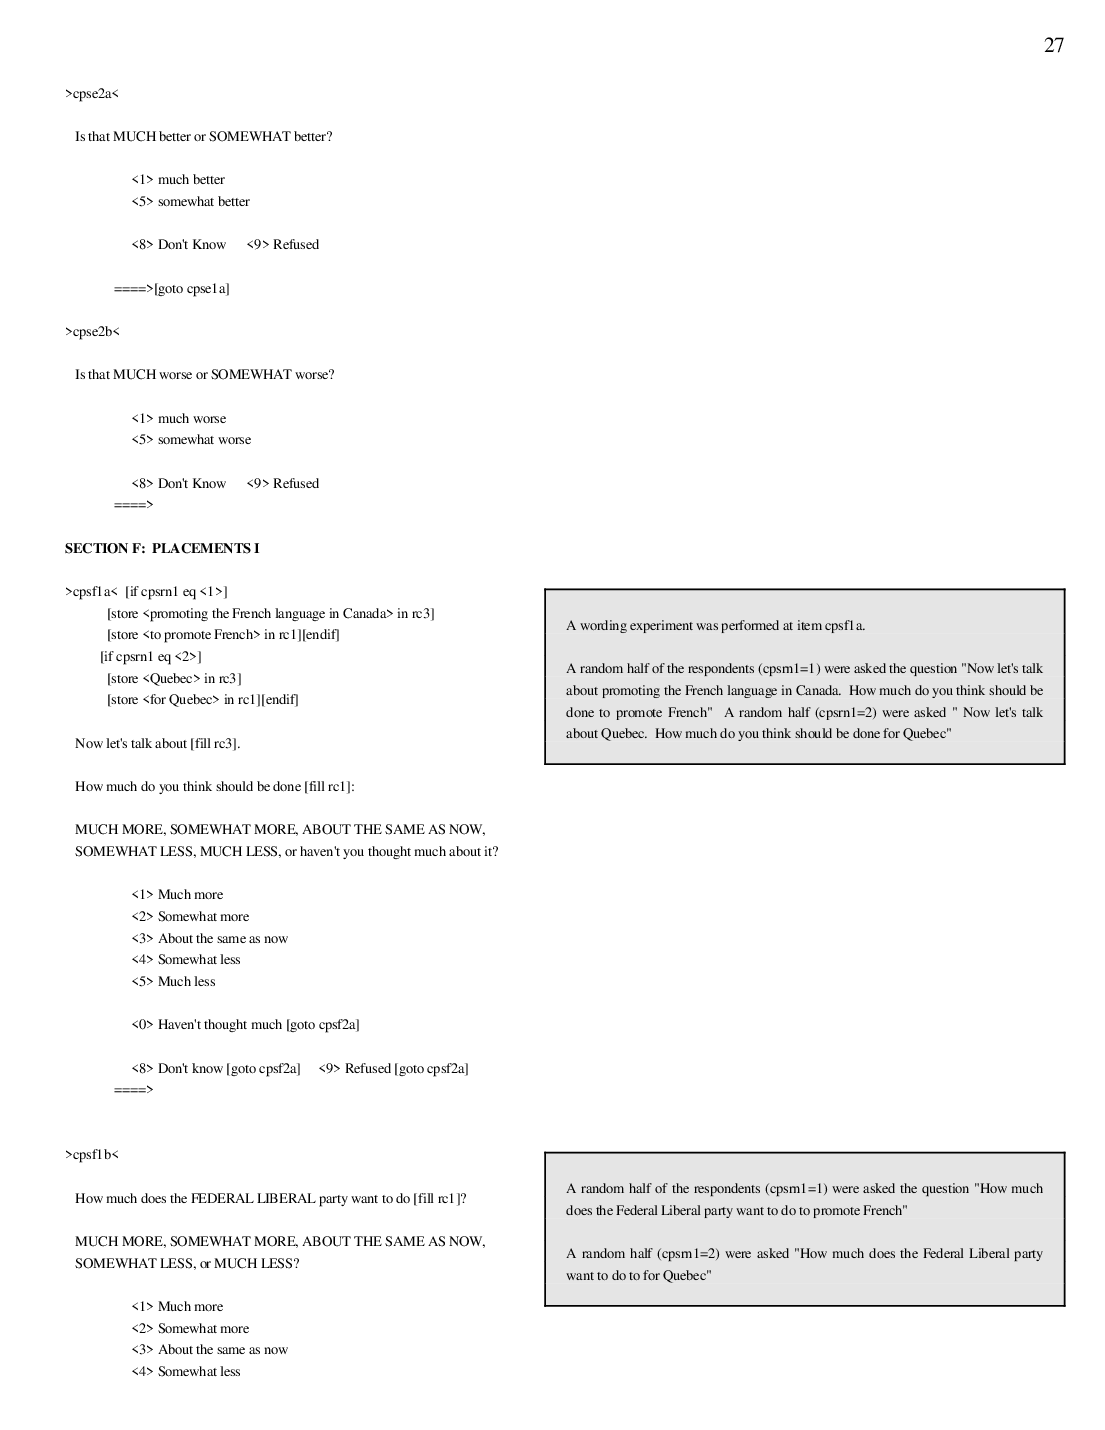
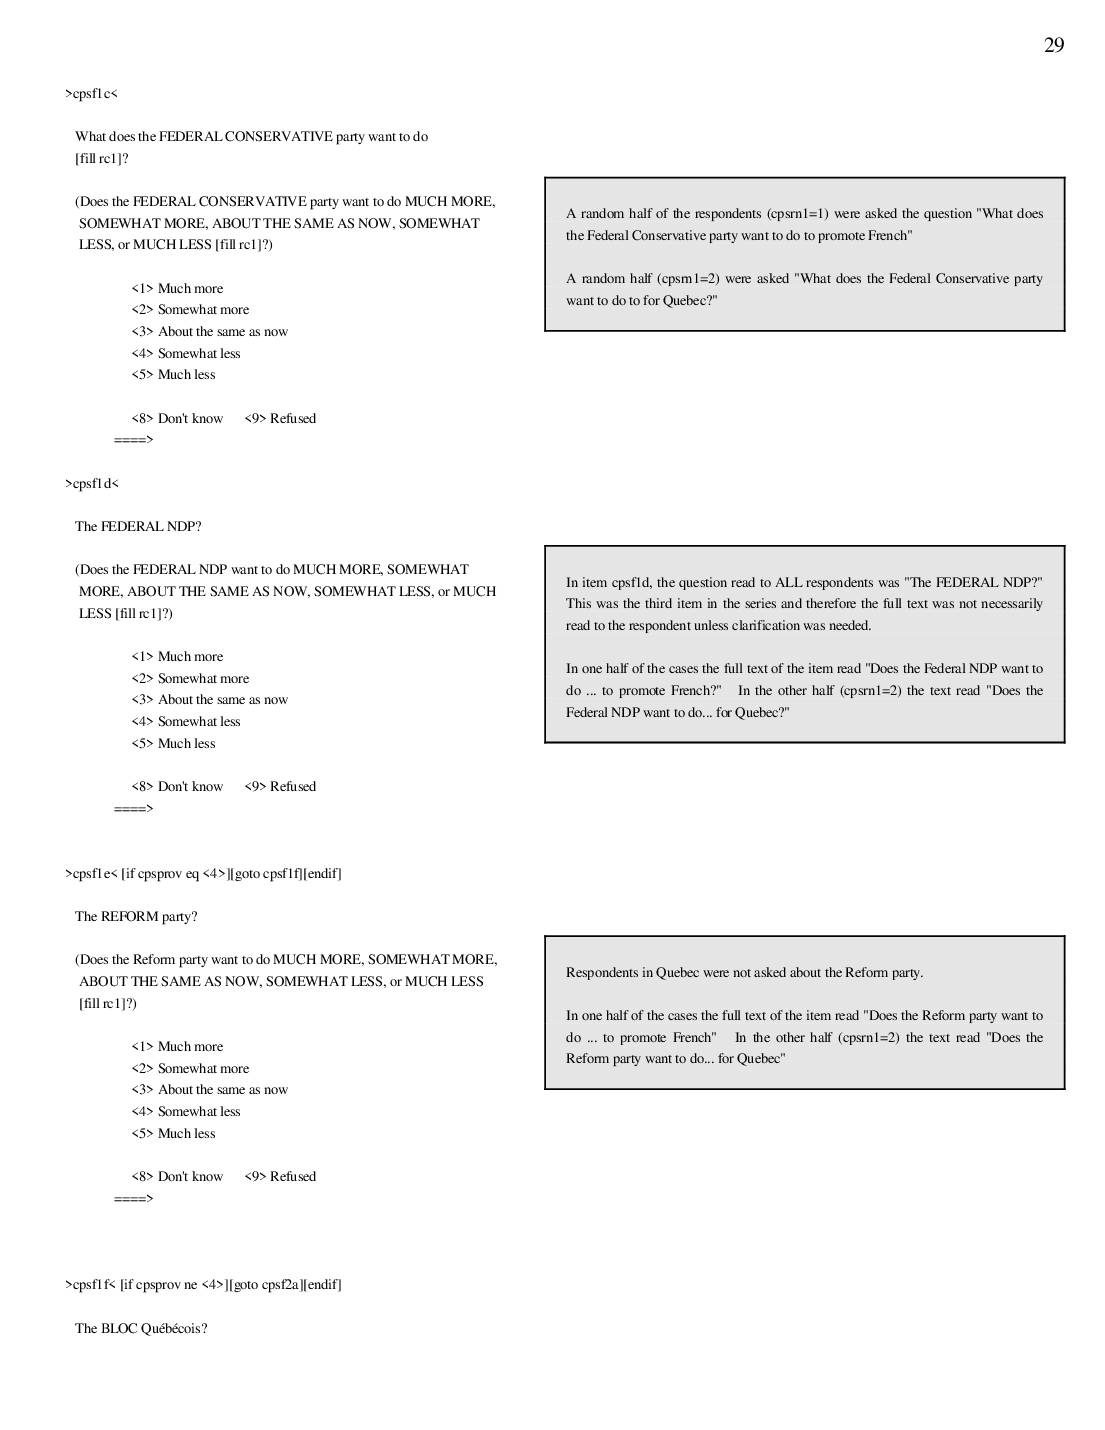
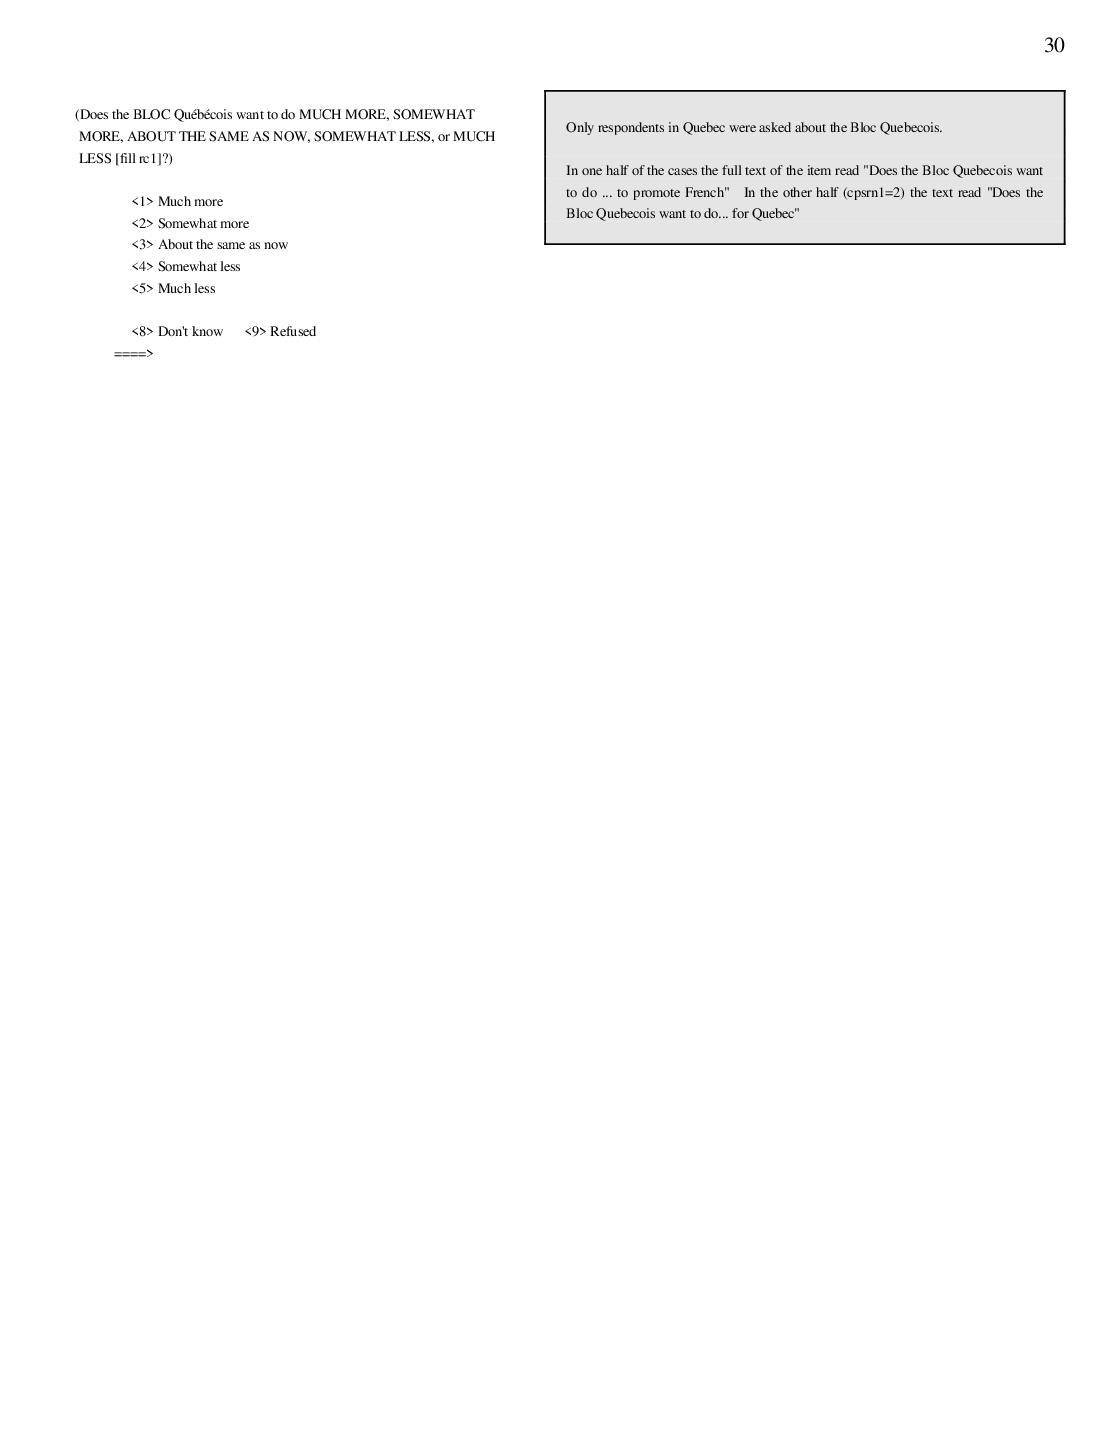
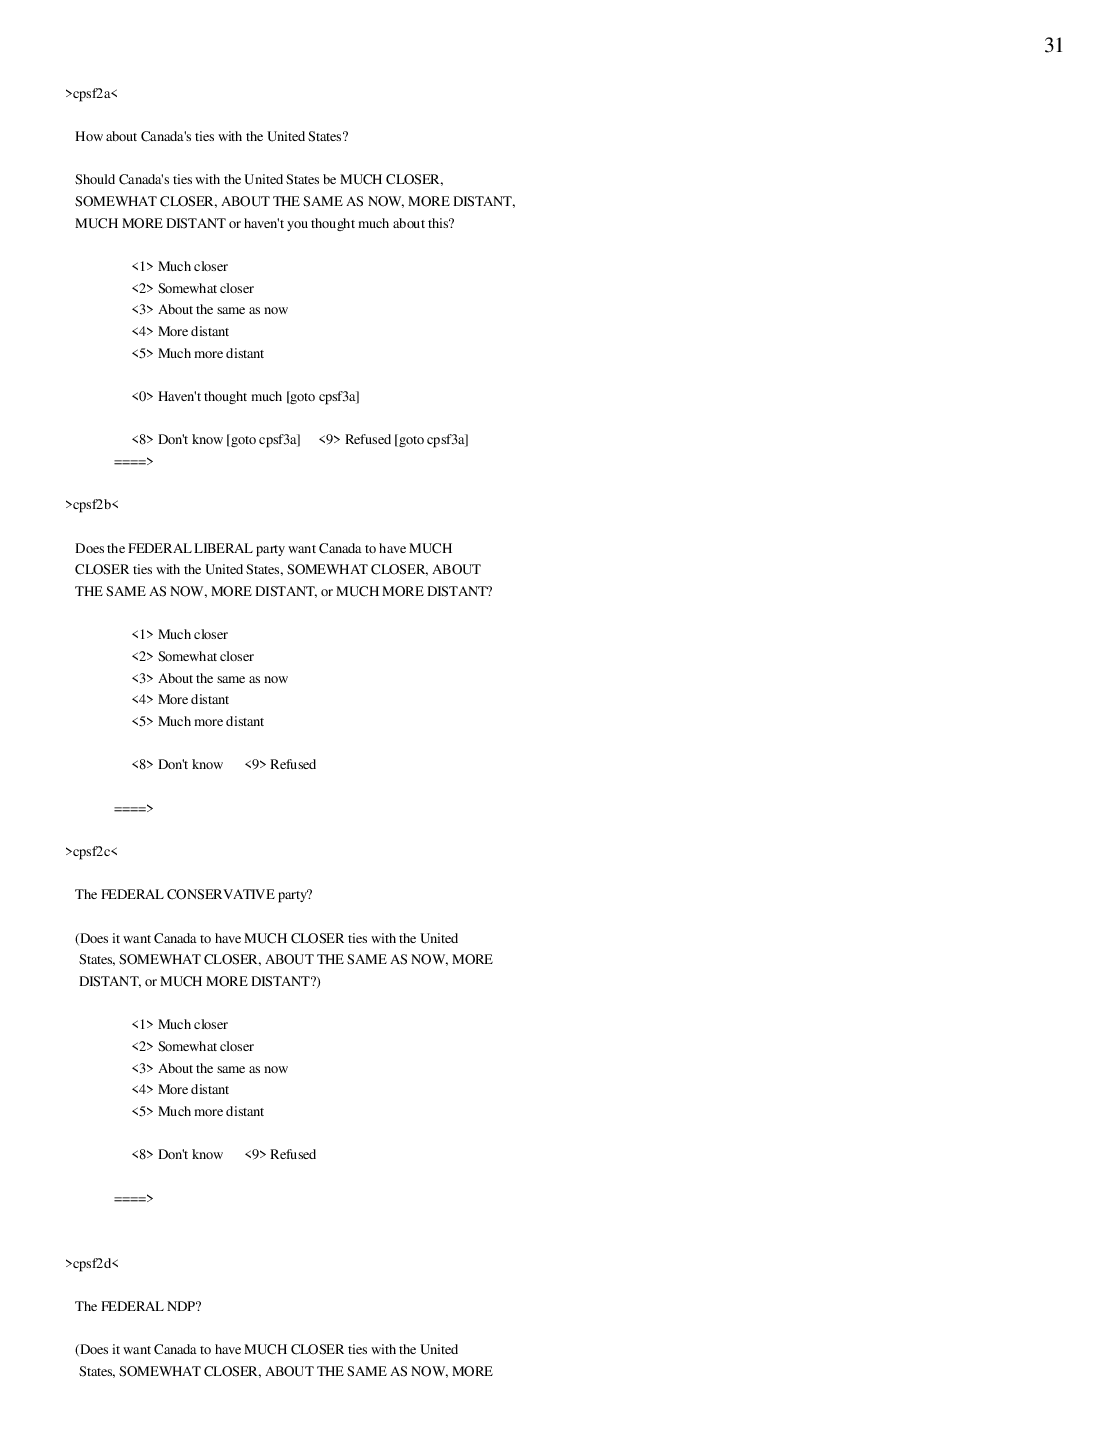
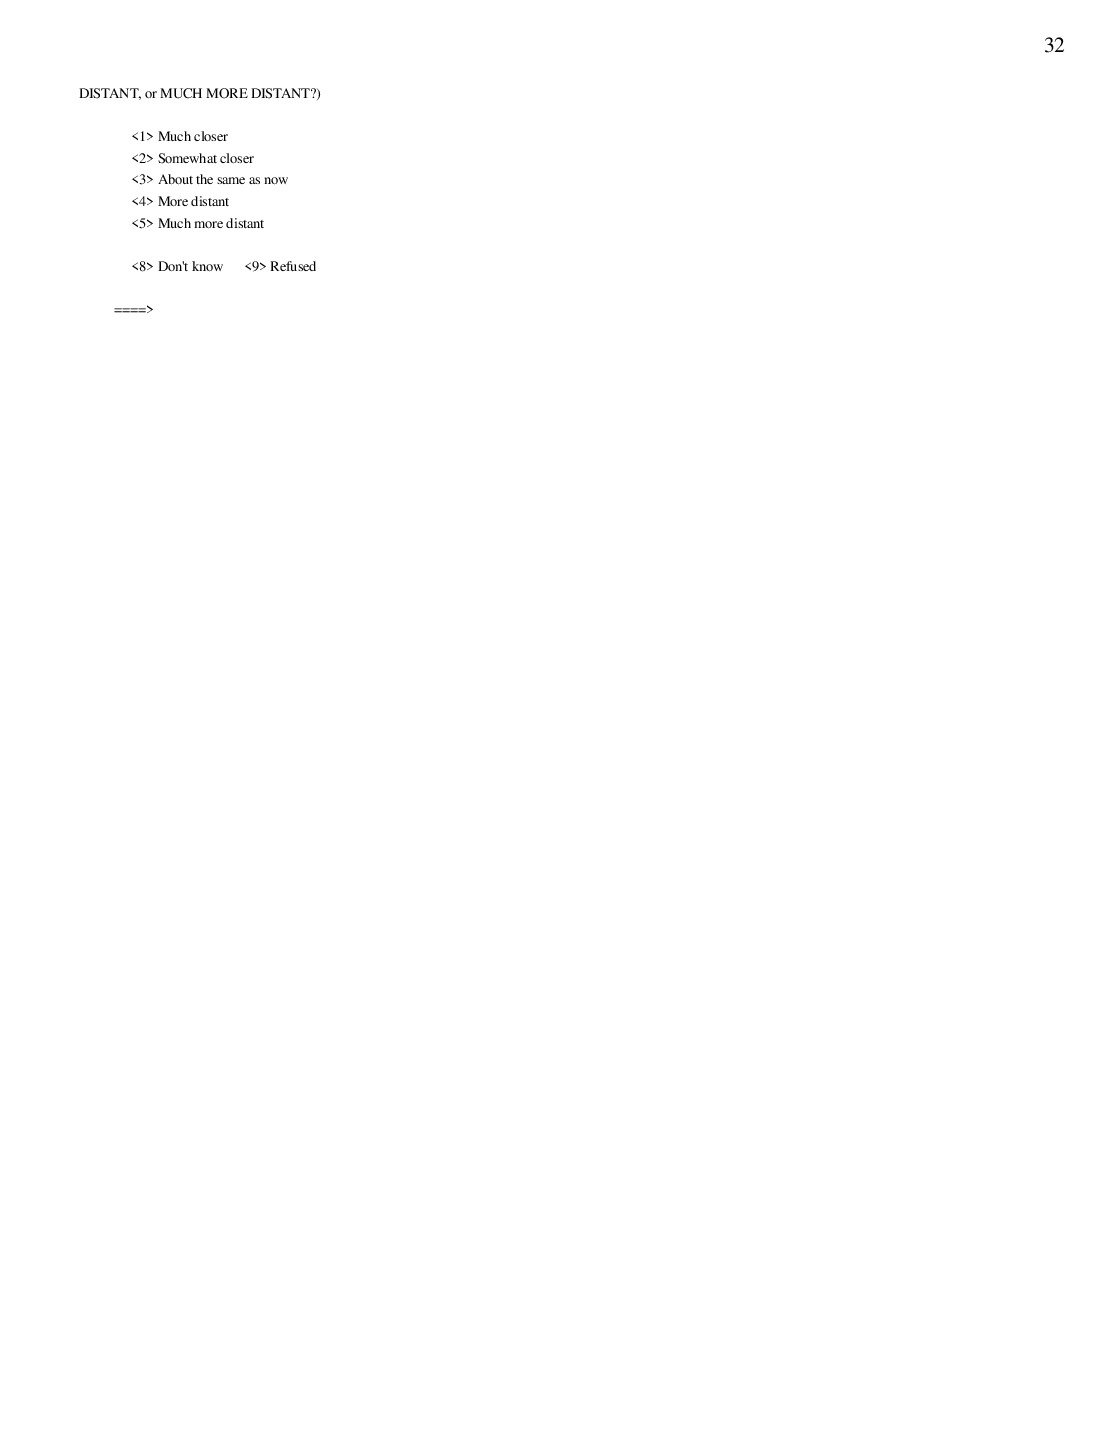
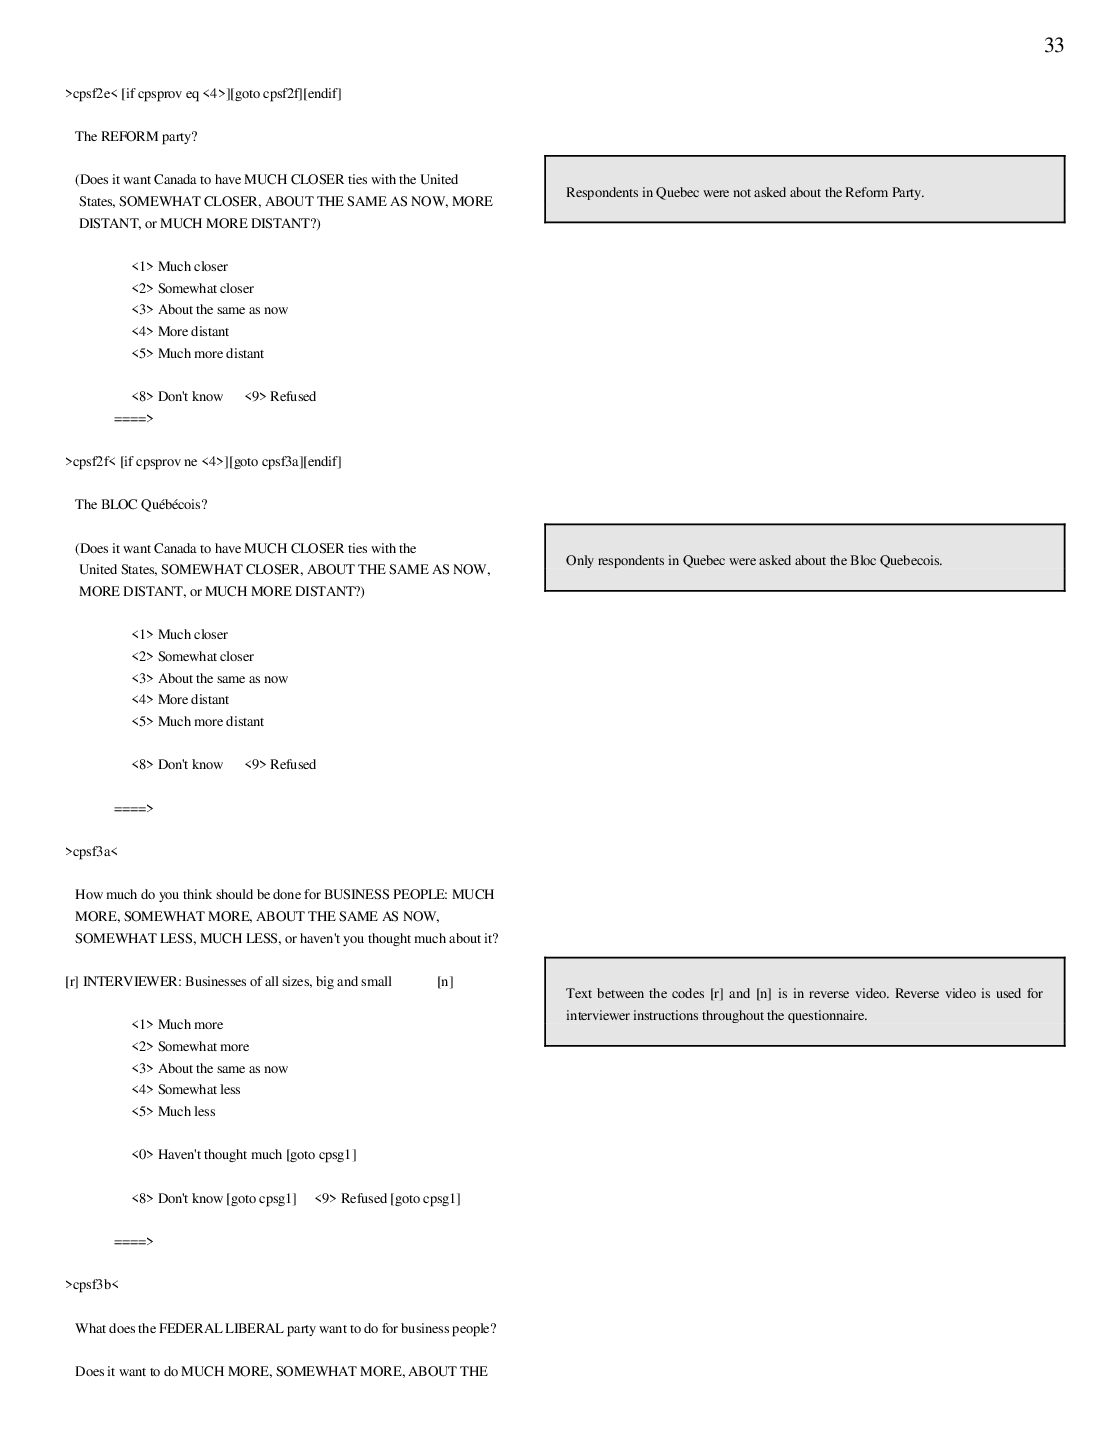
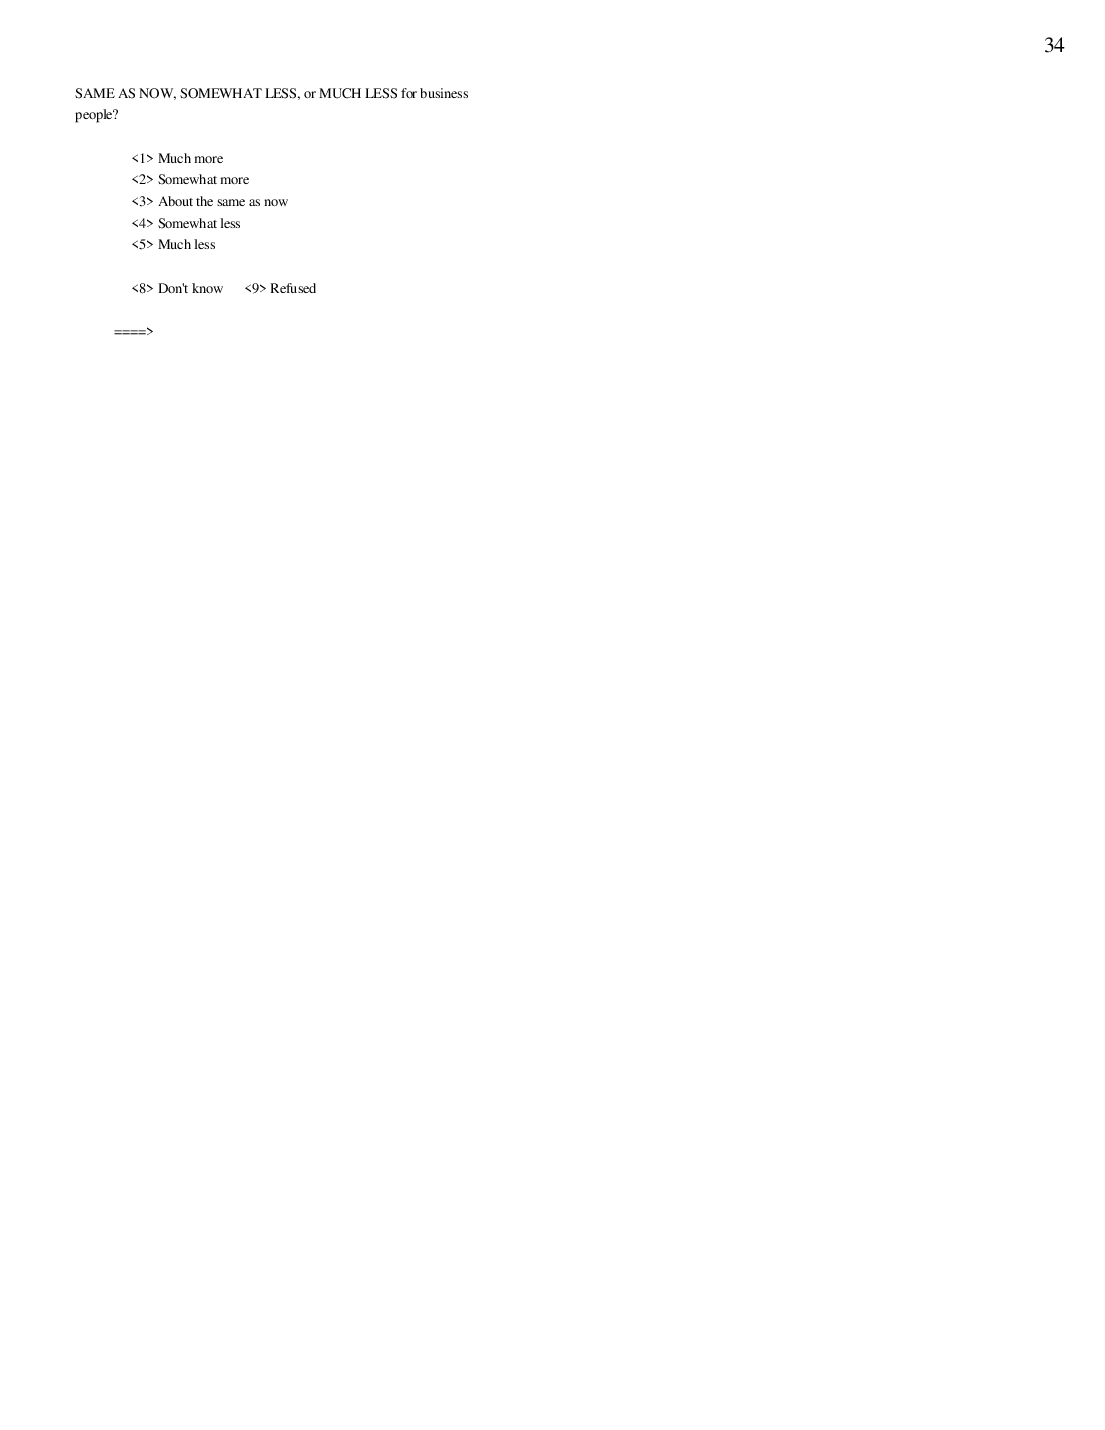
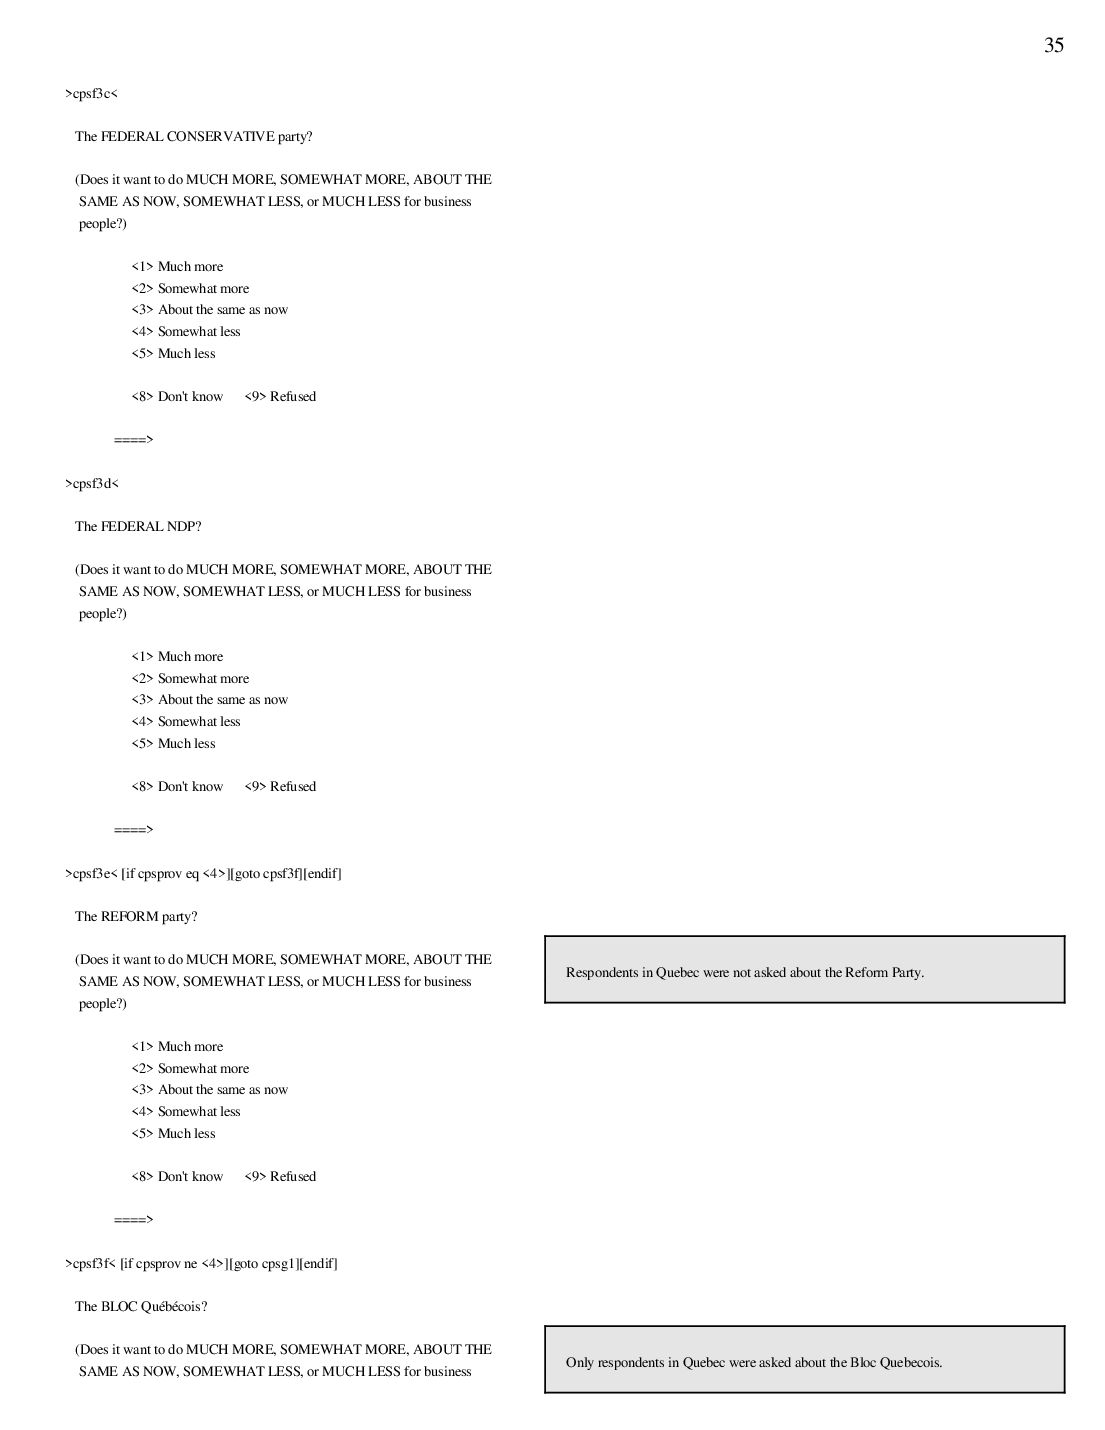
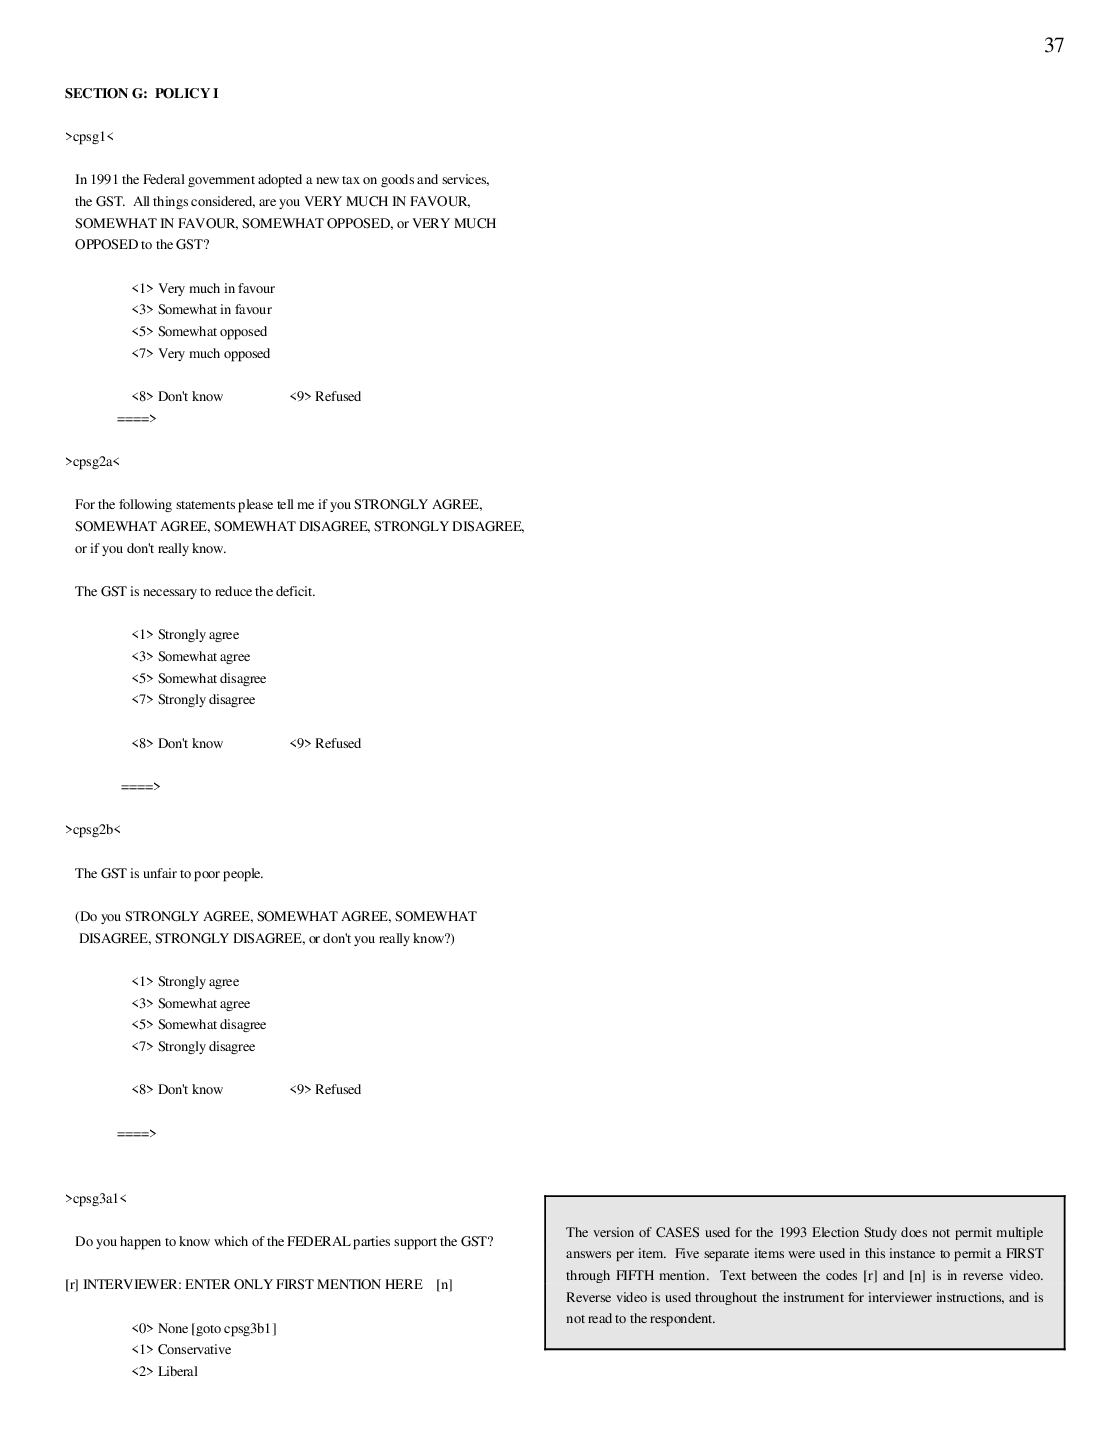
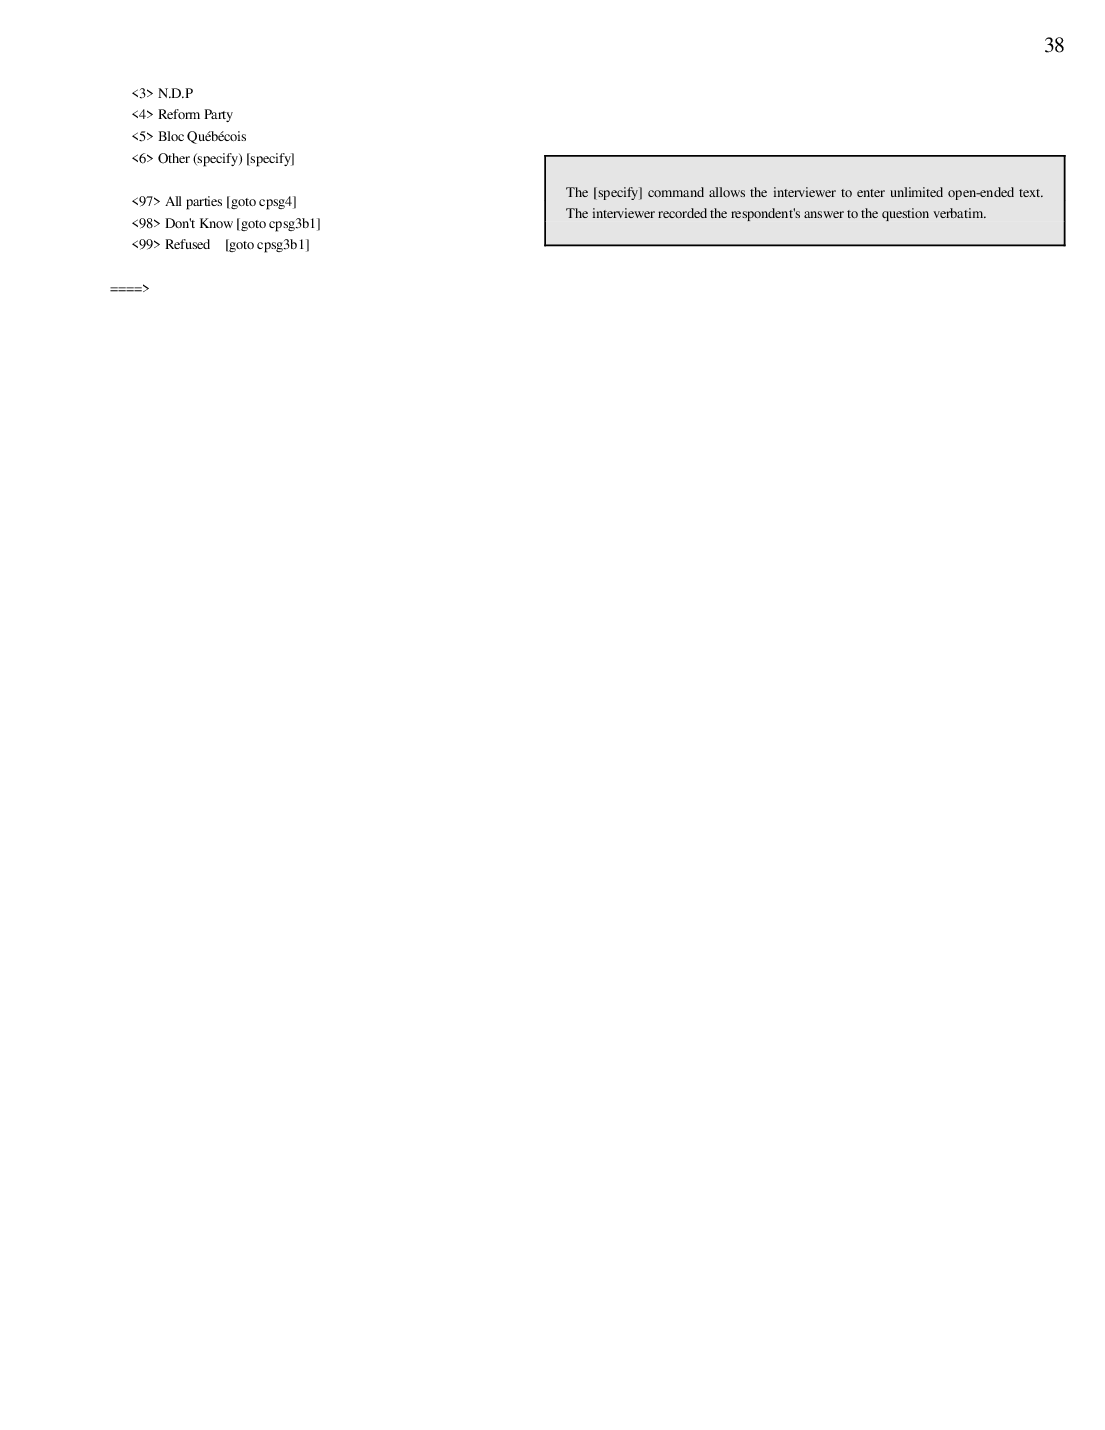
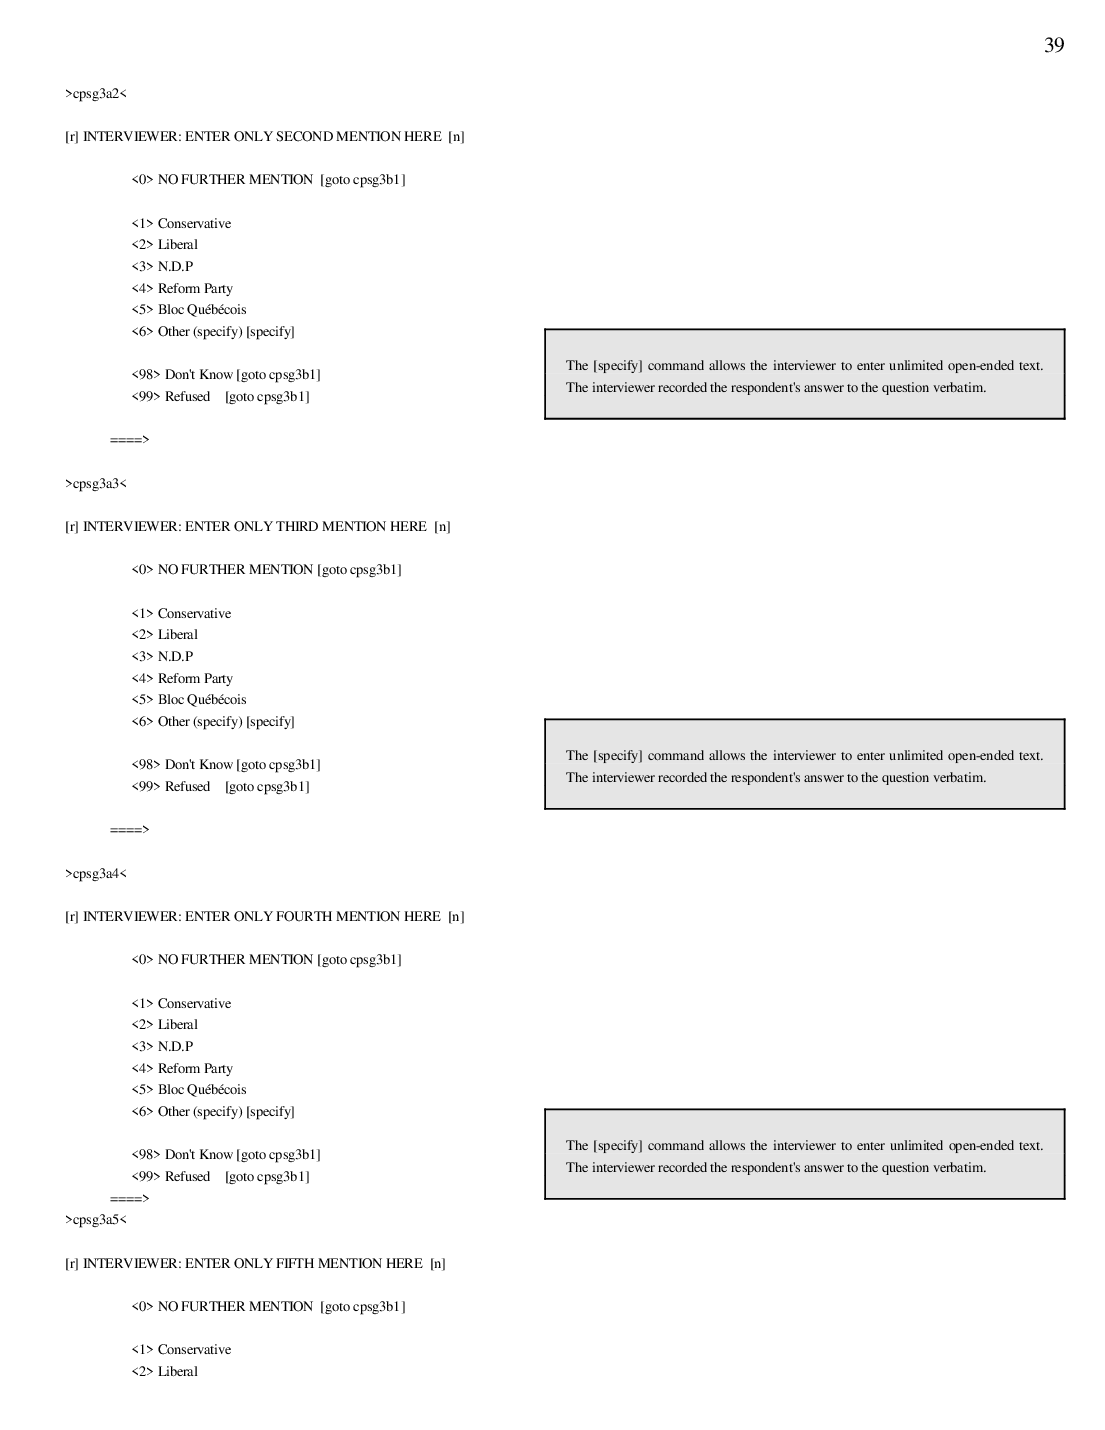
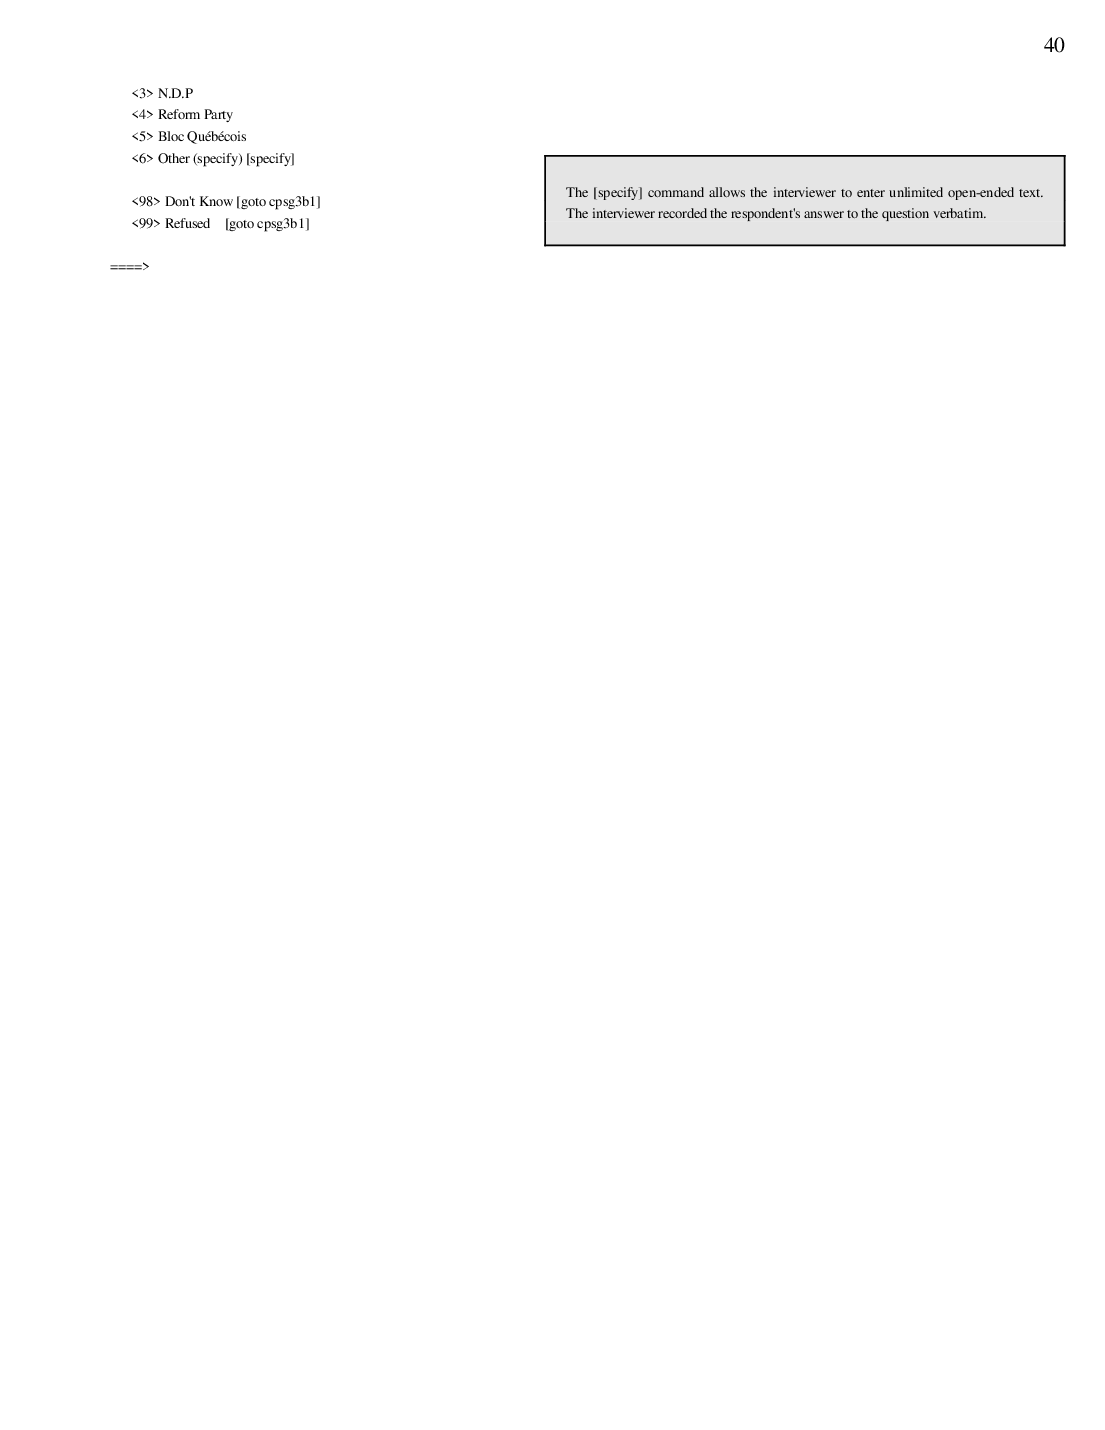
Étude électorale canadienne 1993 · cpsg1 (la TPS) : p. 37 · le PDF complet
Des codes illisibles
| CPSIGEN | CPSA3 | CPSG1 | CPSO11 | CPSA2 |
|---|---|---|---|---|
| 5 | 1 | 7 | 1 | 1 |
| 5 | 2 | 5 | 1 | 1 |
| 5 | 99 | 7 | 1 | 1 |
| 1 | 2 | 7 | 1 | 1 |
| 5 | 1 | 3 | 1 | 1 |
| 1 | 2 | 5 | 1 | 1 |
Que veut dire 7 ?
Étude électorale canadienne 1993 · données brutes et codebook
Lire une entrée
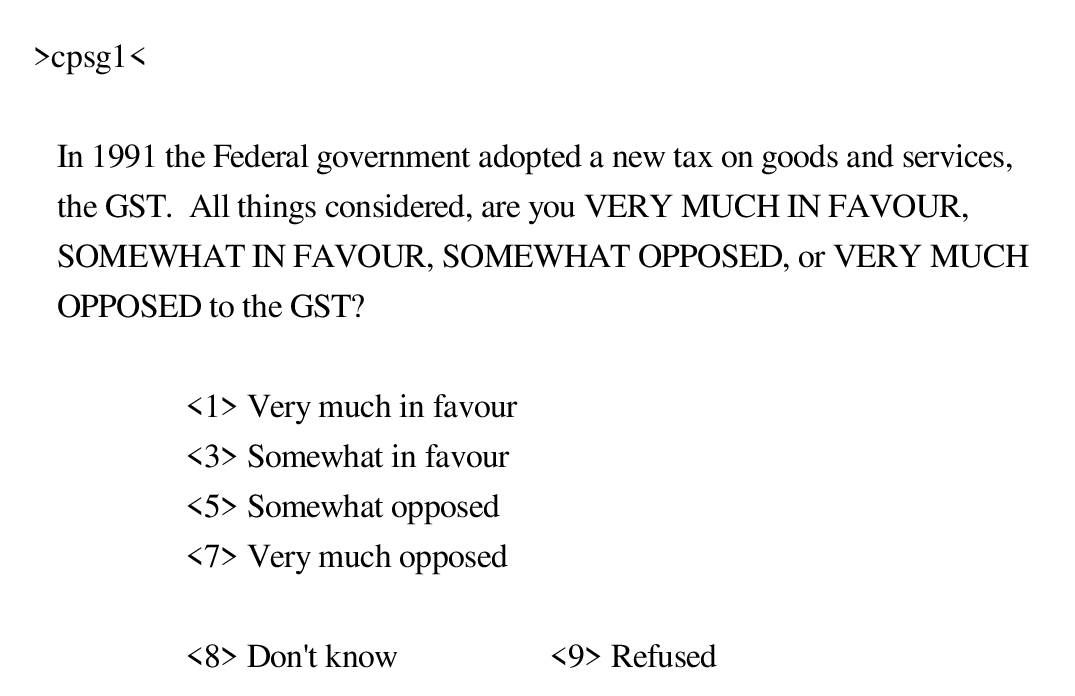
Quatre choses à trouver, chaque fois.
Le codebook, dans R
> attr(df_raw$cps25_demsat, "label")
[1] "On the whole, how satisfied are you with\nthe way democracy works in Canada?"
> table(df_raw$cps25_demsat)
    1     2     3     4     5
 2971 10576  4313  1594   726
> ▍Pause
Quinze minutes.
Recoder
Des codes du sondage aux catégories de votre question.
df_raw et df_clean
df_raw lecture seulementdf_clean| idnum | refprov | … | cpsg1 | … | cpso3 | … | rlink |
|---|---|---|---|---|---|---|---|
| ⋮ | ⋮ | ⋮ | ⋮ | ⋮ | ⋮ | ⋮ | ⋮ |
| id | ses_education | … |
|---|---|---|
| 1 | ||
| 2 | ||
| 3 | ||
| 4 | ||
| ⋮ | ⋮ | |
| 4871 |
4 871 lignes × 872 colonnes
4 871 lignes × 1 colonne
df_clean <- data.frame(id = 1:nrow(df_raw)) df_clean$ses_education <- case_when(
df_raw$cpso3 <= 5 ~ "secondaire_ou_moins",
df_raw$cpso3 <= 7 ~ "collegial",
df_raw$cpso3 <= 11 ~ "universitaire"
)Poser une question à R
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
educ <- 1:11
df_raw$cpso3 · Étude électorale canadienne 1993
Si…, alors…
df_clean$ses_education <- case_when(
  df_raw$cpso3 <= 5  ~ "secondaire_ou_moins",
  df_raw$cpso3 <= 7  ~ "collegial",
  df_raw$cpso3 <= 11 ~ "universitaire"
)
Trois catégories, trois règles.
Quatre façons, un résultat
df_clean$universitaire <- NA
df_clean$universitaire[df_raw$cpso3 >= 8] <- 1
df_clean$universitaire[df_raw$cpso3 < 8] <- 0df_clean$universitaire <-
ifelse(df_raw$cpso3 >= 8, 1, 0)df_clean$universitaire <-
if_else(df_raw$cpso3 >= 8, 1, 0)df_clean$universitaire <- case_when(
df_raw$cpso3 >= 8 ~ 1,
df_raw$cpso3 < 8 ~ 0
)> table(df_clean$universitaire, useNA = "ifany") 0 1 <NA> 1715 619 2537
Dans ce cours : le tidyverse, case_when().
Opérationnaliser
Trois catégories, dans R
> table(df_raw$cpso3)
1 2 3 4 5 6 7 8 9 10 11 1 57 67 466 648 182 294 191 303 70 55
> df_clean$ses_education <- case_when( df_raw$cpso3 <= 5 ~ "secondaire_ou_moins", df_raw$cpso3 <= 7 ~ "collegial", df_raw$cpso3 <= 11 ~ "universitaire" )
> table(df_clean$ses_education, useNA = "ifany")
collegial secondaire_ou_moins universitaire <NA>
476 1239 619 2537 > ▍Toujours vérifier
Toutes les variables de 0 à 1
Trois variables, trois étendues différentes.
1 = ce que dit le nom
Dans le sondage, plus le code monte, moins on est satisfait.
Comment case_when() lit vos données
df_clean$satisfaction <- case_when( df_raw$cps25_demsat == 1 ~ 1, df_raw$cps25_demsat == 2 ~ 0.67, df_raw$cps25_demsat == 3 ~ 0.33, df_raw$cps25_demsat == 4 ~ 0 ) De 0 à 1, dans R
> table(df_raw$cps25_demsat)
1 2 3 4 5
2971 10576 4313 1594 726 > df_clean$satisfaction <- case_when( df_raw$cps25_demsat == 1 ~ 1, df_raw$cps25_demsat == 2 ~ 0.67, df_raw$cps25_demsat == 3 ~ 0.33, df_raw$cps25_demsat == 4 ~ 0 )
> table(df_clean$satisfaction, useNA = "ifany")
0 0.33 0.67 1 <NA>
1594 4313 10576 2971 726 > ▍Les valeurs manquantes
-99, « ne sait pas », NA et NaN.
Quatre sortes de vide
R le lit comme un nombre
Une vraie réponse
Question jamais posée
0 / 0→NaN dans R Un calcul sans réponse
Étude électorale canadienne 2025 · 20 180 personnes
La moyenne, pas à pas
> ▍ - 1
- 2
- 3
- 4
Étude électorale canadienne 2025 · cps25_lr_scale_bef_1
Chaque variable coûte des lignes
age + ses_education + gauche_droite + satisfaction + ne_canada + vote drop_na() garde 13 404 personnes sur 20 180 · 6 776 retirées (34 %)
- Retirer les NA seulement sur les variables de votre analyse
drop_na(df_clean, age, ses_education, gauche_droite)garde 16 962 - Les personnes retirées ne sont pas tirées au hasard : elles peuvent être différentes de celles qui restent
Une base propre
Six personnes, avant et après
df_raw | cps25_ | cps25_ | cps25_ | cps25_ | cps25_ | cps25_ |
|---|---|---|---|---|---|
| 69 | 9 | 8 | 4 | 2 | 2 |
| 61 | 9 | 3 | 2 | 1 | 3 |
| 54 | 11 | 7 | 2 | 1 | 2 |
| 63 | 8 | -99 | 2 | 1 | 1 |
| 45 | 4 | -99 | 5 | 1 | NA |
| 68 | 7 | 8 | 3 | 2 | NA |
df_clean | age | ses_ | gauche_ | satisfaction | ne_ | vote |
|---|---|---|---|---|---|
| 69 | universitaire | 8 | 0 | 0 | 2. Conservative Party |
| 61 | universitaire | 3 | 0.67 | 1 | 3. NDP |
| 54 | universitaire | 7 | 0.67 | 1 | 2. Conservative Party |
| 63 | universitaire | NA | 0.67 | 1 | 1. Liberal Party |
| 45 | secondaire_ou_moins | NA | NA | 1 | NA |
| 68 | collegial | 8 | 0.33 | 0 | NA |
Six vraies personnes de l’Étude électorale canadienne 2025
Garder, nommer, sauvegarder
> df_clean$age <- as.numeric(df_raw$cps25_age_in_years) df_clean$vote <- as_factor(df_raw$cps25_votechoice)
> head(df_clean)
id ses_education satisfaction ne_canada gauche_droite age vote 1 1 universitaire 0.00 0 8 69 2. Conservative Party 2 2 universitaire 0.67 1 3 61 3. NDP 3 3 universitaire 0.67 1 7 54 2. Conservative Party 4 4 universitaire 1.00 0 7 28 1. Liberal Party 5 5 universitaire 0.67 1 NA 63 1. Liberal Party 6 6 universitaire 0.33 1 5 28 2. Conservative Party
> saveRDS(df_clean, "ces2025_clean.rds")
> ▍Le script entier, 1 de 7
# POL-2000 · séance 4 · Préparer ses données avec R
# À refaire chez vous, ligne par ligne, Ctrl + Entrée.
# La règle : df_raw ne change jamais. On remplit df_clean, une colonne à la fois.
library(ces)
library(dplyr)
library(tidyr)
library(haven)
# 1. L'Étude électorale de 1993
df_raw <- get_ces("1993")
df_clean <- data.frame(id = 1:nrow(df_raw))Le script entier, 2 de 7
# 2. Opérationnaliser la scolarité : trois choix
table(df_raw$cpso3)
df_clean$ses_universitaire <- case_when(
df_raw$cpso3 >= 8 ~ 1,
df_raw$cpso3 < 8 ~ 0
)
df_clean$ses_education <- case_when(
  df_raw$cpso3 <= 5  ~ "secondaire_ou_moins",
  df_raw$cpso3 <= 7  ~ "collegial",
  df_raw$cpso3 <= 11 ~ "universitaire"
)
df_clean$ses_education_detail <- as_factor(df_raw$cpso3)
table(df_clean$ses_education, useNA = "ifany") # toujours vérifierLe script entier, 3 de 7
# 3. Votre travail : l'Étude électorale de 2025
df_raw <- readRDS("ces2025.rds")   # sauvegardé à la séance 2, sinon get_ces("2025")
df_clean <- data.frame(id = 1:nrow(df_raw))

attr(df_raw$cps25_demsat, "label")
table(df_raw$cps25_demsat)Le script entier, 4 de 7
# 4. De 0 à 1, dans le sens du nom
df_clean$satisfaction <- case_when(
  df_raw$cps25_demsat == 1 ~ 1,
  df_raw$cps25_demsat == 2 ~ 0.67,
  df_raw$cps25_demsat == 3 ~ 0.33,
  df_raw$cps25_demsat == 4 ~ 0
)
table(df_clean$satisfaction, useNA = "ifany")Le script entier, 5 de 7
# 5. La scolarité et le lieu de naissance
table(df_raw$cps25_education)
df_clean$ses_education <- case_when(
  df_raw$cps25_education <= 5  ~ "secondaire_ou_moins",
  df_raw$cps25_education <= 7  ~ "collegial",
  df_raw$cps25_education <= 11 ~ "universitaire"
)
table(df_clean$ses_education, useNA = "ifany")

table(df_raw$cps25_bornin_canada)
df_clean$ne_canada <- case_when(
  df_raw$cps25_bornin_canada == 1 ~ 1,
  df_raw$cps25_bornin_canada == 2 ~ 0
)
table(df_clean$ne_canada, useNA = "ifany")Le script entier, 6 de 7
# 6. Les valeurs manquantes
mean(df_raw$cps25_lr_scale_bef_1)
df_clean$gauche_droite <- na_if(df_raw$cps25_lr_scale_bef_1, -99)
mean(df_clean$gauche_droite)
mean(df_clean$gauche_droite, na.rm = TRUE)

# 7. Compléter et sauvegarder df_clean
df_clean$age <- as.numeric(df_raw$cps25_age_in_years)
df_clean$vote <- as_factor(df_raw$cps25_votechoice)
head(df_clean)
saveRDS(df_clean, "ces2025_clean.rds")Le script entier, 7 de 7
# 8. Des données tidy
relig_income |>
  pivot_longer(!religion, names_to = "revenu", values_to = "n")

# 9. À vous : cps25_interest_gen_1 a aussi des -99. Mettez-la dans df_clean, puis sa moyenne.L’examen 1 ouvre aujourd’hui
Examen 1
Avant jeudi prochain
Deux choses
 Datacamp Intermediate R · Conditionals and Control Flow
Jeudi prochain
L’inférence statistique.
Merci.
Département de science politiqueFaculté des sciences sociales POL-2000 · Automne 2026
1 / 58